C#에서 .so 파일을 사용하는 방법 (P/Invoke)

아래는 JNI)

public void setData(){
if(memType == 0){
System.out.println("실시간 시세인지 지연시세인지 지정하세요.");
_data = null;
return;
}
if(upcode == null || cnt <= 0){
_data = null;
return;
}
try{
_data = ReadVolHigherList(memType, language, market, upcode, cnt).getBytes();
}catch(NullPointerException null_e){
_data = null;
}catch(Exception e){
_data = null;
}
}
public byte[] getData(){
return _data;
}


Java에 JNI(Java Native Interface)가 있듯이,
C#에는 C언어로 작성된 라이브러리(*.so 또는 *.dll)를 불러와 사용할 수 있는 P/Invoke (Platform Invoke)라는 강력한 기능이 있습니다.

Java의 JNI보다 훨씬 간단하고 직관적이라는 장점이 있습니다.

1. C#에서 .so 파일을 사용하는 방법 (P/Invoke)

C#에서는 System.Runtime.InteropServices namespace의 [DllImport] 어트리뷰트(Attribute)를 사용해 네이티브 함수를 선언합니다.

앞서 보셨던 Java 코드 속 ReadVolHigherList 함수가 C언어의 .so 파일 안에 구현되어 있다고 가정할 때, C#에서는 다음과 같이 작성하여 호출할 수 있습니다.

C#
 
using System;
using System.Runtime.InteropServices;

class Program
{
    // 1. C언어 공유 라이브러리(.so 또는 .dll)의 함수를 외부 함수로 선언
    // 리눅스 환경이라면 "libname.so", 윈도우 환경이라면 "name.dll"이 됩니다.
    [DllImport("libshmmanager.so", CallingConvention = CallingConvention.Cdecl)]
    public static extern IntPtr ReadVolHigherList(
        int memType, 
        [MarshalAs(UnmanagedType.LPStr)] string language, 
        [MarshalAs(UnmanagedType.LPStr)] string market, 
        [MarshalAs(UnmanagedType.LPStr)] string upcode, 
        int cnt
    );

    static void Main(string[] args)
    {
        // 2. 평소 C# 메서드를 쓰듯이 자유롭게 호출 가능
        IntPtr nativePtr = ReadVolHigherList(1, "K", "A", "001", 100);

        if (nativePtr != IntPtr.Zero)
        {
            // 3. C언어가 반환한 포인터 데이터를 C# 문자열이나 데이터로 변환 (Marshal 활용)
            string result = Marshal.PtrToStringAnsi(nativePtr);
            Console.WriteLine("Result from .so: " + result);
        }
    }
}

2. Java JNI와 C# P/Invoke의 차이점

구분 Java (JNI) C# (P/Invoke)
작동 방식 JNI 규격에 맞는 C언어 브릿지 함수(JNIEXPORT 등)를 중간에 다시 작성해야 해서 구조가 복잡함 별도의 브릿지 코드 작성 없이 [DllImport] 선언만으로 C 함수를 곧바로 호출 가능
코드 복잡도 비교적 높음 (JVM 관련 메모리 핸들링 코드 필요) 매우 낮음 (속성 하나로 끝남)
마샬링(변환) 자바 객체와 C 포인터 간 변환을 직접 복잡하게 구현해야 할 때가 많음 문자열, 기본 타입, 구조체 등을 Marshal 클래스와 어트리뷰트로 자동/반자동 처리

💡 참고 사항 (.NET의 크로스 플랫폼 지원)

  • 과거 .NET Framework 시절에는 윈도우의 *.dll 위주로 사용되었으나, 최신 .NET(Core / .NET 6/7/8/9 등)은 리눅스 환경을 완벽히 지원하므로 리눅스용 C 라이브러리인 *.so 파일을 P/Invoke를 통해 그대로 로드하여 호출할 수 있습니다.

통합관리자 한 명이 Git Bash 터미널에서 a_branch, b_branch, c_branch를 순서대로 새시작에 통합하는 방법을 실제 명령어로 설명하겠습니다.

핵심은 a_branch, b_branch, c_branch를 한 번에 무조건 병합하는 것이 아니라, 새시작에 하나씩 병합하고 각 결과를 검증하는 것입니다. 이 방식이면 어느 단계에서 충돌이나 빌드 오류가 발생했는지 쉽게 추적할 수 있습니다.
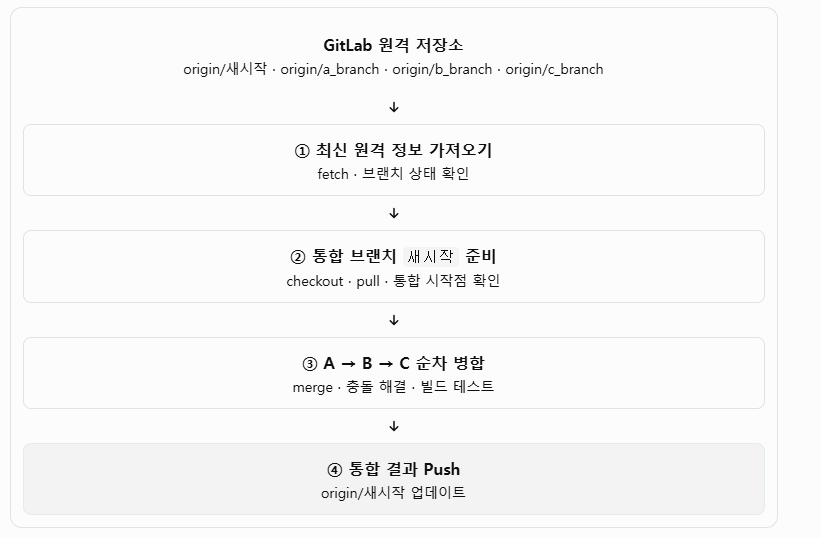
가장 권장하는 방법은 통합관리자가 새시작을 최신 상태로 만든 후, A → B → C 순서로 병합하고, 각 단계에서 충돌 해결과 빌드 검증을 수행하는 것입니다.

여기서는 현재 사용 중인 APM Client 저장소와 원격 저장소 origin을 기준으로 하겠습니다.

원격 저장소 URL은 기존 로그에 나온 다음 주소를 예로 사용합니다.

http://10.143.114.112:7443/APMClient/APMKoreaClient.git

실제 origin 주소가 다르다면 아래 명령어를 실행하기 전에 확인해야 합니다.

1. 전체 병합 흐름


2. 1단계 — 저장소와 브랜치 상태 확인

통합관리자의 PC에서 Git Bash를 열고 프로젝트 저장소로 이동합니다.

cd ~/source/APMKoreaClient/APMKoreaClient

현재 위치와 저장소를 확인합니다.

pwd
git rev-parse --show-toplevel
git remote -v
git branch -a
git status

정상적인 상태라면 다음과 같은 원격 브랜치가 보여야 합니다.

remotes/origin/새시작
remotes/origin/a_branch
remotes/origin/b_branch
remotes/origin/c_branch

실제 브랜치명이 정확히 일치하는지 확인하세요. Git 브랜치명은 대소문자와 문자 차이를 구분합니다.

주의: git status에 커밋하지 않은 변경 사항이 표시되면 먼저 처리해야 합니다. 통합관리자가 직접 수정한 파일이 있다면 내용을 확인하고 커밋하거나 안전하게 보관하세요. 다른 사람의 변경 사항을 무조건 버리는 git reset --hard나 git clean은 실행하지 마세요.

3. 2단계 — GitLab의 최신 브랜치 정보 가져오기

git fetch origin --prune

이 명령은 원격 브랜치 정보를 갱신합니다. 현재 로컬 소스가 자동으로 바뀌지는 않습니다.

원격 브랜치별 최신 커밋을 확인합니다.

git log -1 --oneline origin/새시작
git log -1 --oneline origin/a_branch
git log -1 --oneline origin/b_branch
git log -1 --oneline origin/c_branch

브랜치별 차이도 확인할 수 있습니다.

git log --oneline --graph --decorate --all -30

이 명령은 각 브랜치의 커밋 관계를 그래프로 보여줍니다.

4. 3단계 — 새시작을 통합 기준으로 준비

먼저 통합관리자가 로컬 새시작 브랜치로 이동합니다.

git switch 새시작

로컬 브랜치가 아직 없다면 다음 명령을 사용합니다.

git switch --track -c 새시작 origin/새시작

이미 로컬 브랜치가 있는 경우에는 두 번째 명령을 실행하지 않습니다.

이제 원격의 최신 새시작을 반영합니다.

git pull --ff-only origin 새시작

--ff-only는 단순히 앞으로 이동할 수 있을 때만 업데이트하므로, 로컬과 원격의 이력이 갈라져 있으면 임의로 병합하지 않고 중단합니다. 오류가 발생하면 원인을 확인한 뒤 진행하세요.

현재 브랜치를 확인합니다.

git branch --show-current
git status

결과가 새시작이고 작업 트리가 깨끗한 상태여야 합니다.

통합 전 백업 브랜치 생성

기존 통합 기준으로 돌아갈 수 있도록 백업 브랜치를 만듭니다.

git branch backup/새시작-before-integration-20261029

이 명령은 현재 커밋을 가리키는 백업 브랜치를 생성합니다. 이미 같은 이름이 있다면 다른 날짜나 이름을 사용하세요.

5. 4단계 — a_branch를 새시작에 병합

먼저 병합 대상인 A의 최신 커밋을 확인합니다.

git fetch origin
git log --oneline 새시작..origin/a_branch

두 번째 명령은 현재 새시작에는 없고 origin/a_branch에 있는 커밋을 보여줍니다.

이제 병합합니다.

git merge --no-ff origin/a_branch -m "Merge a_branch into 새시작"

--no-ff는 가능하면 병합 커밋을 남겨서 A의 작업이 언제 통합되었는지 추적하기 쉽게 합니다.

병합 결과 확인

git status
git log --oneline --graph --decorate -15

충돌이 없다면 다음을 수행합니다.

  1. Visual Studio에서 APM.sln을 엽니다.

  2. 전체 솔루션을 빌드합니다.

  3. A가 수정한 기능을 테스트합니다.

  4. 정상이라면 새시작을 원격에 반영합니다.

git push origin 새시작

이제 GitLab의 새시작에 A의 변경 사항이 반영됩니다.

중요: 병합 후 빌드가 실패했다면 B와 C의 작업을 계속 병합하기 전에 원인을 해결하는 것이 좋습니다.

6. 5단계 — b_branch를 새시작에 병합

A의 병합과 테스트가 완료되었다고 가정합니다.

먼저 최신 원격 정보를 다시 가져옵니다.

git fetch origin

B의 작업 내역을 확인합니다.

git log --oneline 새시작..origin/b_branch

B의 변경 사항을 통합합니다.

git merge --no-ff origin/b_branch -m "Merge b_branch into 새시작"

이때 Git은 현재 새시작에 이미 반영된 A의 변경 사항과 B의 변경 사항을 비교합니다.

충돌이 발생하지 않은 경우

git status
git log --oneline --graph --decorate -15

Visual Studio에서 전체 솔루션을 빌드하고 B의 기능을 검증합니다.

정상이라면 Push합니다.

git push origin 새시작

충돌이 발생한 경우

예를 들어 MainForm.cs에서 충돌이 발생했다면 다음과 같이 확인합니다.

git status

결과 예시:

On branch 새시작
You have unmerged paths.

Unmerged paths:
  both modified: MainForm.cs

Git은 충돌한 파일의 어떤 코드를 최종적으로 사용해야 하는지 판단할 수 없습니다.

1. 충돌 파일을 직접 수정합니다.

public void LoadData()
{
    Console.WriteLine("데이터 조회");
    Console.WriteLine("A의 조회 진행률 표시");
    Console.WriteLine("B의 조회 오류 로그 기록");
}

위 코드는 두 기능을 모두 유지하는 것이 요구 사항에 맞는 경우의 예시입니다. 실제 코드에서는 기존 함수의 흐름과 변수, 예외 처리, 호출 순서를 검토해야 합니다.

2. 충돌 표시가 남아 있는지 확인합니다.

git diff --check
git diff

충돌 표시인 <<<<<<<, =======, >>>>>>>가 코드에 남아 있지 않은지 확인합니다.

3. 해결한 파일을 스테이징합니다.

git add MainForm.cs

충돌한 파일이 여러 개라면 모든 파일을 확인한 후 각각 git add합니다.

4. 병합을 완료합니다.

git status
git commit -m "Merge b_branch into 새시작 - resolve conflicts"

이 명령은 충돌 해결 후 병합 커밋을 생성합니다. 이 시점에 빌드와 기능 테스트를 반드시 수행하세요.

5. 검증에 성공한 경우에만 Push합니다.

git push origin 새시작

다른 파일에서도 충돌이 발생했다면 동일한 방식으로 해결합니다. Git은 충돌이 모두 해결되고 병합이 완료되기 전까지 정상적인 병합 상태로 전환되지 않습니다.

7. 6단계 — c_branch를 새시작에 병합

C도 B와 같은 방식으로 진행합니다. 다만 C를 병합하는 시점에는 A와 B의 변경 사항이 이미 새시작에 반영되어 있어야 합니다.

git fetch origin
git log --oneline 새시작..origin/c_branch
git merge --no-ff origin/c_branch -m "Merge c_branch into 새시작"

충돌이 없다면 다음 순서로 진행합니다.

git status
git log --oneline --graph --decorate -15

전체 솔루션 빌드와 C의 기능을 테스트한 후 Push합니다.

git push origin 새시작

충돌이 발생했다면 B에서 설명한 절차와 같이 충돌 파일을 수정하고 git add, git commit으로 병합을 완료한 다음 테스트하고 Push합니다.

8. 7단계 — 최종 통합 결과 확인

A, B, C 세 브랜치의 병합이 끝났다면 다음 명령으로 최종 상태를 확인합니다.

git status
git branch --show-current
git log --oneline --graph --decorate -20

정상 상태의 기준은 다음과 같습니다.

  • 현재 브랜치가 새시작입니다.

  • 작업 트리에 미커밋 변경이나 미해결 충돌이 없습니다.

  • 로그에서 A, B, C의 변경 사항과 병합 이력을 확인할 수 있습니다.

  • GitLab의 새시작에 최종 커밋이 Push되어 있습니다.

원격 저장소의 최신 상태도 확인합니다.

git fetch origin
git status -sb

로컬 새시작과 origin/새시작이 동일하다면 일반적으로 다음과 같이 표시됩니다.

## 새시작...origin/새시작

마지막으로 Visual Studio에서 APM.sln 전체 빌드와 주요 기능 테스트를 수행합니다.

9. 전체 명령어 모음

아래는 충돌이 발생하지 않고 각 단계의 빌드와 테스트가 성공한 경우의 전체 명령어입니다. 한꺼번에 붙여 넣기보다는 각 단계의 결과를 확인하면서 실행하세요.

# 1. 저장소로 이동
cd ~/source/APMKoreaClient/APMKoreaClient

# 2. 현재 상태 및 원격 저장소 확인
git status
git remote -v
git branch -a

# 3. 최신 원격 정보 가져오기
git fetch origin --prune

# 4. 통합 브랜치로 이동
git switch 새시작

# 5. 최신 통합 브랜치 반영
git pull --ff-only origin 새시작

# 6. 통합 전 백업
git branch backup/새시작-before-integration-20261029

# 7. A 병합
git fetch origin
git merge --no-ff origin/a_branch -m "Merge a_branch into 새시작"
# 빌드 및 테스트 후
git push origin 새시작

# 8. B 병합
git fetch origin
git merge --no-ff origin/b_branch -m "Merge b_branch into 새시작"
# 빌드 및 테스트 후
git push origin 새시작

# 9. C 병합
git fetch origin
git merge --no-ff origin/c_branch -m "Merge c_branch into 새시작"
# 빌드 및 테스트 후
git push origin 새시작

# 10. 최종 확인
git fetch origin
git status -sb
git log --oneline --graph --decorate -20

충돌이 발생하면 해당 git merge 명령이 완료되지 않은 상태에서 다음 브랜치로 넘어가지 말고, 충돌 해결 → 커밋 → 빌드 및 테스트 → Push 순으로 처리해야 합니다.

10. Push가 거부되는 경우

다른 개발자가 통합관리자의 작업 도중 새시작에 커밋을 추가했거나 GitLab에서 직접 변경 사항이 들어오면 Push가 거부될 수 있습니다.

이 경우 무조건 강제 Push하지 마세요.

git fetch origin
git status

로컬과 원격의 이력을 비교한 뒤, 원격에만 있는 변경 사항을 검토합니다. 원격 새시작이 단순히 앞으로 진행된 경우에는 다음과 같이 반영할 수 있습니다.

git merge --ff-only origin/새시작

이 명령이 실패한다면 이력이 갈라진 것이므로 상황을 확인하고 별도로 조정해야 합니다. git push --force로 다른 사람의 커밋을 덮어쓰는 것은 피하세요.

또한 GitLab에서 새시작을 Protected Branch로 설정했다면 직접 Push가 거부될 수 있습니다. 그 경우에는 통합 브랜치에 대한 권한 정책에 따라 Merge Request로 반영해야 합니다.

최종 권장 운영 방식

구분통합관리자 운영 원칙
새시작 공통 통합 기준으로 유지
a_branch A의 작업을 검토 후 병합
b_branch A의 병합 이후 변경 사항과 충돌 여부를 검토
c_branch A와 B의 병합 이후 변경 사항과 충돌 여부를 검토
병합 시점 한 브랜치씩 병합하고 각 단계에서 검증
최종 확인 전체 솔루션 빌드, 기능 테스트, 원격 Push 확인

핵심은 a_branch, b_branch, c_branch를 한 번에 무조건 병합하는 것이 아니라, 새시작에 하나씩 병합하고 각 결과를 검증하는 것입니다. 이 방식이면 어느 단계에서 충돌이나 빌드 오류가 발생했는지 쉽게 추적할 수 있습니다.

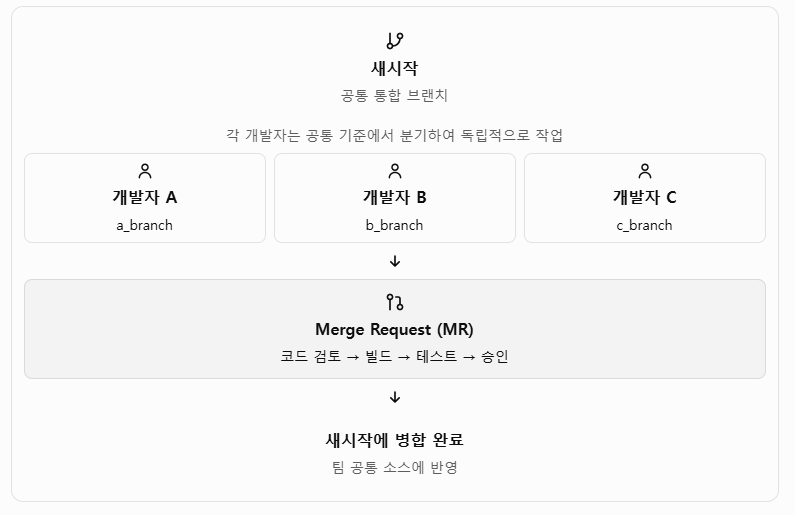
동료 A, B, C가 각자 a_branch, b_branch, c_branch에서 독립적으로 개발하고, 검증이 완료된 코드만 새시작 브랜치로 통합하는 방식이 좋습니다.

현재 사용 중인 GitLab 저장소 APMKoreaClient를 기준으로 설명하겠습니다.

1. 권장 브랜치 구조


핵심은 A, B, C가 각자 Push하더라도 새시작에 직접 Push하지 않고, Merge Request를 통해서만 통합하는 것입니다.

2. 1단계 — 각 개발자가 자신의 브랜치에서 작업

세 개발자의 브랜치는 모두 기존 새시작을 기준으로 생성한다고 가정합니다.

개발자작업 브랜치예시 작업
A a_branch APM 메인 화면 수정
B b_branch Redis 통신 기능 수정
C c_branch 파일 다운로드 기능 수정

Visual Studio에서 각 개발자는 자신의 브랜치를 체크아웃한 상태로 작업합니다.

작업을 마치면 각자 다음 순서로 처리합니다.

  1. 소스 수정 및 빌드

  2. Git 변경 내용 확인

  3. Stage 및 Commit

  4. 자신의 브랜치로 Push

예를 들어 A가 다음 명령을 실행하면 됩니다.

git add .
git commit -m "APM 메인 화면 수정"
git push -u origin a_branch

B와 C도 자신의 브랜치 이름으로 동일하게 작업합니다.

이 단계에서는 세 개발자의 코드가 새시작에 자동으로 들어가지 않습니다.

3. 2단계 — GitLab에서 Merge Request 생성

A가 작업을 마쳤다면 GitLab에서 다음과 같이 Merge Request(MR)를 생성합니다.

A 개발자의 Merge Request 예시

Source branch (변경 사항)

a_branch

Target branch (통합 대상)

새시작

GitLab 프로젝트에서 Merge Requests → New merge request를 선택한 뒤, 위와 같이 Source와 Target 브랜치를 지정합니다.

MR을 생성하면 검토자가 변경된 파일과 커밋 내용을 확인할 수 있습니다. A의 변경 사항이 정상이라면 승인 후 Merge합니다.

B와 C도 같은 방식으로 각각 MR을 생성합니다.

  • b_branch → 새시작

  • c_branch → 새시작

MR의 Target은 반드시 새시작으로 지정해야 합니다.

4. 3단계 — 세 브랜치를 순서대로 통합

예를 들어 다음 순서로 통합한다고 가정하겠습니다.

  1. A의 코드 통합

    a_branch → 새시작 MR을 검토하고 병합합니다.

  2. B의 코드 통합

    b_branch → 새시작 MR을 검토합니다. A가 수정한 코드와 충돌하지 않는지 확인한 뒤 병합합니다.

  3. C의 코드 통합

    c_branch → 새시작 MR을 검토합니다. A와 B의 변경 사항까지 고려하여 빌드 및 테스트한 후 병합합니다.

이때 중요한 점이 있습니다. A가 병합된 뒤 B와 C의 브랜치는 이전 새시작을 기준으로 만들어졌을 수 있습니다. GitLab이 자동으로 병합할 수 있더라도, B와 C의 코드를 최신 새시작 기준으로 검증하는 것이 안전합니다.

서로 다른 파일을 수정했다면 쉽게 통합될 수 있지만, 동일한 메서드나 공통 라이브러리를 수정했다면 충돌 또는 기능상 문제가 발생할 수 있습니다.

5. 충돌이 발생하면 어떻게 하나요?

예를 들어 A와 B가 모두 APMPublicLib의 같은 함수를 수정했다면, 두 MR을 병합할 때 충돌이 발생할 수 있습니다.

이 경우 다음 절차를 권장합니다.

  1. 먼저 병합된 새시작의 최신 코드를 확인합니다.

  2. 충돌이 발생한 개발자는 자신의 브랜치에 최신 새시작을 반영합니다.

  3. 충돌 파일을 수정하여 두 변경 사항을 조정합니다.

  4. 빌드와 테스트를 진행하고 자신의 브랜치에 다시 Push합니다.

  5. MR을 다시 검토하고 병합합니다.

예를 들어 B가 b_branch에서 작업 중이라면, 다음과 같이 최신 통합 브랜치를 가져와 병합할 수 있습니다.

git fetch origin
git switch b_branch
git merge origin/새시작

충돌이 발생하면 파일을 수정하고 해결한 뒤 커밋 및 Push합니다. 단, 이 명령은 b_branch의 작업 트리에 변경을 일으키므로 미커밋 변경 사항이 있다면 먼저 커밋하거나 Stash로 보관하세요.

6. 가장 중요한 설정: 새시작 브랜치 보호

GitLab 관리자 또는 프로젝트 Maintainer에게 새시작 브랜치를 보호 브랜치(Protected Branch)로 설정하도록 요청하는 것이 좋습니다.

가능한 설정은 다음과 같습니다.

  • 일반 개발자는 a_branch, b_branch, c_branch에 자유롭게 Push

  • 새시작에는 지정된 담당자만 직접 Push 가능하도록 제한

  • 일반적인 코드 반영은 Merge Request를 통해 진행

  • 가능하면 MR 승인과 CI 빌드·테스트를 병합 조건으로 설정

이렇게 하면 실수로 새시작에 직접 Push하여 다른 개발자의 코드를 덮어쓰거나, 검증되지 않은 코드가 공통 브랜치에 반영되는 위험을 줄일 수 있습니다.

7. 최종 운영 방식

단계담당자작업
1 A, B, C 각자 브랜치에서 개발
2 A, B, C 커밋 및 개인 브랜치 Push
3 A, B, C 새시작을 대상으로 MR 생성
4 리뷰 담당자 코드 검토 및 빌드·테스트
5 지정된 병합 담당자 승인된 MR을 순서대로 병합
6 전체 개발자 최신 새시작 기준으로 다음 작업 진행

추천 원칙: 새시작은 항상 통합과 검증이 완료된 코드만 유지하고, 개발자들은 각자 브랜치에서 자유롭게 개발합니다. 문제가 있는 코드는 개인 브랜치에 남겨 두고 수정한 뒤 다시 MR을 올리면 됩니다.

이 구조를 적용하면 동료의 잘못된 코드가 내 작업 환경에 자동으로 들어오는 일을 방지하면서도, 검증된 코드를 팀 전체에 안전하게 공유할 수 있습니다.

동료의 코드를 무조건 Pull하면 내 PC의 소스 코드가 변경되고, 그 코드에 오류가 있다면 내 개발 작업까지 영향을 받을 수 있습니다.

특히 현재 개발 중인 APM Client처럼 여러 프로젝트(APM, APMPublicLib, APMFileDownload, APMWPF)가 연결된 환경에서는 동료의 변경 사항 때문에 빌드가 실패하거나 기존 기능이 동작하지 않을 수도 있습니다.

따라서 좋은 방법은 동료의 코드를 내 개발 환경에 바로 반영하지 않고, 별도의 브랜치에서 검증한 다음 문제가 없을 때만 통합하는 것입니다.

1. 가장 추천하는 방법: 기능별 브랜치로 개발하기

현재 사용 중인 새시작 브랜치를 공통 개발 브랜치로 두고, 개인별 작업 브랜치를 별도로 만드는 방식입니다.

GitLab: 새시작

공통 개발 브랜치

내 PC

feature/apm-client

독립 개발

내 코드 수정 및 테스트

동료 PC

feature/redis-timeout

독립 개발

동료 코드 수정 및 테스트

검증 후 새시작에 통합

코드 리뷰 → 빌드 → 테스트 → 병합

이렇게 하면 동료가 잘못된 코드를 올려도 내 작업 브랜치에 자동으로 반영되지 않습니다. 내가 원할 때만 해당 변경 사항을 가져올 수 있습니다.

2. 동료의 코드가 잘못되어도 내 개발을 보호하는 방법 3가지

방법 A. 개인 작업 브랜치 사용 — 가장 추천

새시작에서 개인 브랜치를 만들어 개발합니다. 동료의 코드는 검토할 때만 가져오고, 문제가 있으면 통합하지 않습니다.

장점: 서로의 개발 작업을 독립적으로 유지

방법 B. Pull 전에 변경 사항 검토

Fetch로 원격 커밋을 확인하고, 동료가 어떤 파일을 수정했는지 비교한 후 Pull 여부를 결정합니다.

장점: 불필요한 코드 변경을 미리 파악

방법 C. GitLab Merge Request로 검증 후 통합

동료는 별도 브랜치에 Push하고 Merge Request를 생성합니다. 코드 리뷰, 빌드 및 테스트를 통과한 후에만 새시작에 병합합니다.

장점: 문제가 있는 코드가 공통 브랜치에 들어오는 것을 예방

3. 현재 프로젝트에서 실제로 설정하는 방법

현재 PC에는 새시작 브랜치가 이미 있으므로, Visual Studio에서 다음과 같이 진행할 수 있습니다.

  1. Git → 분기 관리 또는 Git 리포지토리 창을 엽니다.

  2. 현재 브랜치 새시작을 선택합니다.

  3. 새 로컬 브랜치를 만듭니다. 예를 들어 feature/apm-client라고 지정합니다.

  4. 기준은 현재 새시작으로 하고, 가능하면 새 브랜치를 체크아웃합니다.

  5. 이후 내 소스 수정과 커밋은 feature/apm-client에서 진행합니다.

이제 내 커밋은 새시작에 직접 반영되지 않습니다. 개인 브랜치를 원격 GitLab에 Push하면 백업 및 다른 PC에서의 작업도 가능합니다.

단, 이미 새시작에서 수정했지만 커밋하지 않은 파일이 있다면 브랜치를 바꾸기 전에 변경 사항을 확인해야 합니다. Visual Studio가 변경 사항을 유지해 주는 경우도 있지만, 충돌이나 유실 위험을 피하려면 먼저 커밋하거나 Stash로 보관하는 편이 안전합니다.

4. 동료의 코드를 가져와서 테스트만 하고 싶다면?

이 경우에는 내 개발 브랜치에 바로 Pull하지 말고 테스트용 브랜치에서 먼저 검증하면 됩니다.

예를 들어 동료가 feature/redis-timeout 브랜치에 코드를 올렸다고 가정하겠습니다.

  1. 내 작업 브랜치 feature/apm-client는 그대로 유지합니다.

  2. 별도의 test/redis-timeout 브랜치를 생성합니다.

  3. 테스트 브랜치에 동료의 변경 사항을 통합합니다.

  4. Visual Studio에서 빌드하고 Redis 요청·응답, 타임아웃 등 관련 기능을 테스트합니다.

  5. 문제가 있으면 테스트 브랜치를 버리고, 정상이라면 필요한 변경만 내 작업 브랜치에 반영합니다.

이렇게 하면 동료의 코드가 잘못되어도 기존 개발 환경을 유지할 수 있습니다.

5. 이미 잘못된 코드가 새시작에 반영되었다면?

동료의 코드가 공통 브랜치까지 병합된 상황은 별도로 처리해야 합니다.

  • 내 로컬에만 잘못된 코드가 들어온 경우: 정상 커밋으로 복구하거나 안전한 브랜치로 돌아갑니다.

  • GitLab의 새시작에도 잘못된 커밋이 올라간 경우: 문제가 된 커밋을 확인한 뒤 Revert로 되돌리는 방식을 우선 검토합니다.

  • 다른 개발자도 이미 그 코드를 가져간 경우: 공통 브랜치의 이력을 강제로 덮어쓰기보다 팀과 복구 방식을 협의합니다.

Revert는 기존 커밋을 삭제하는 대신 그 변경을 취소하는 새 커밋을 만듭니다. 공유 브랜치에서 안전하게 복구할 때 유용합니다.

최종 추천

현재 APM Client 프로젝트에는 다음 구조가 가장 적합합니다.

브랜치용도
새시작 팀 공통 개발 기준
feature/apm-client 내 개인 개발
feature/redis-timeout 동료의 개인 개발
test/redis-timeout 동료 코드의 사전 검증

개발이 완료되면 Merge Request를 통해 검토와 테스트를 거쳐 새시작에 병합합니다.

가장 중요한 원칙은 공통 브랜치를 개인 개발 공간으로 사용하지 않는 것입니다. 개인 브랜치에서 개발하면 동료의 잘못된 코드 때문에 내 작업이 중단될 위험을 크게 줄일 수 있습니다. 다만 공통 라이브러리나 인터페이스가 바뀌면 통합 시 추가 수정이 필요할 수 있습니다.

GitLab을 여러 개발자가 함께 사용하는 경우, Push 전에 동기화하는 이유는 다른 개발자가 먼저 올린 소스 코드를 누락하거나 기존 변경 사항을 덮어쓰는 문제를 방지하기 위해서입니다.

현재 사용 중인 APMKoreaClient 저장소와 새시작 브랜치를 기준으로 설명하겠습니다.

1. Git에서 로컬과 원격 저장소는 어떻게 다른가요?

내 PC (로컬)

Visual Studio에서 수정한 소스와 로컬 커밋

GitLab (원격)

다른 개발자가 Push한 커밋을 포함한 공유 소스

Fetch / Pull / Push로 동기화

Git은 로컬 저장소와 원격 저장소의 커밋 이력을 각각 관리합니다.

  • Fetch: GitLab의 최신 커밋 정보를 가져오지만, 현재 작업 중인 소스 파일에는 직접 반영하지 않습니다.

  • Pull: 원격 변경 사항을 가져온 다음 현재 브랜치에 통합합니다.

  • Push: 로컬에서 만든 커밋을 GitLab에 전송합니다.

중요한 점은 Pull이 단순히 파일을 다운로드하는 작업이 아니라는 것입니다. 로컬 커밋과 원격 커밋의 관계에 따라 자동 병합하거나 충돌 해결이 필요할 수 있습니다.

2. 다른 개발자가 먼저 수정한 경우

예를 들어 두 개발자가 모두 새시작 브랜치를 사용한다고 가정하겠습니다.

처음에는 두 개발자의 저장소가 같은 커밋 A를 기준으로 합니다.

공통 기준 커밋 A

내 PC

커밋 B

내가 수정한 주문 처리 코드

동료 PC

커밋 C

동료가 수정한 조회 처리 코드

두 개발자가 서로의 변경 사항을 아직 받지 않은 상태

동료가 먼저 커밋 C를 GitLab에 Push했는데, 내가 그 사실을 모른 채 커밋 B를 Push하려고 하면 어떻게 될까요?

GitLab에는 이미 A → C라는 이력이 있습니다. 내 PC는 A → B 상태이므로 원격 저장소의 이력을 단순히 B로 진행시킬 수 없습니다.

이때 Git은 일반적으로 다음과 같은 오류를 반환합니다.

! [rejected] 새시작 -> 새시작 (fetch first)
error: failed to push some refs

이것은 내 소스 코드가 잘못되었다는 뜻이 아닙니다. 원격에 내가 아직 받지 않은 커밋이 있어서 Push를 거부했다는 뜻입니다.

3. Pull하면 어떤 일이 발생하나요?

Pull 결과는 로컬과 원격의 변경 이력에 따라 크게 세 가지로 나뉩니다.

경우 ① 원격에 새로운 변경 사항이 없는 경우

내 PC

GitLab

A → B
A → B

두 저장소가 동일하므로 Pull할 변경 사항이 없습니다. Push를 진행하면 됩니다.

경우 ② 원격 변경 사항이 내 변경 사항과 다른 부분인 경우

예를 들어 동료는 조회모듈.cs를 수정하고 나는 주문모듈.cs를 수정했다고 가정하겠습니다.

공통 커밋 A

내 커밋 B

주문모듈.cs 수정

동료 커밋 C

조회모듈.cs 수정

Pull 후 통합

주문모듈.cs와 조회모듈.cs의 변경 사항 모두 유지

Git이 변경 사항을 자동으로 통합할 수 있다면 별도의 충돌 해결 없이 진행할 수 있습니다. 이후 통합된 이력을 Push하면 됩니다.

경우 ③ 같은 파일의 같은 부분을 수정한 경우

예를 들어 APMMain.cs의 같은 메서드를 두 개발자가 서로 다르게 수정했다고 가정하겠습니다.

내가 수정한 코드:

int timeout = 10;

동료가 GitLab에 올린 코드:

int timeout = 30;

Git은 어느 쪽이 올바른 값인지 알 수 없으므로 자동으로 결정하지 못할 수 있습니다. 이를 병합 충돌(Merge Conflict) 이라고 합니다.

충돌이 발생하면 다음과 같은 표시가 나타날 수 있습니다.

<<<<<<< HEAD
int timeout = 10;
=======
int timeout = 30;
>>>>>>> origin/새시작
  • <<<<<<< HEAD: 현재 로컬 브랜치의 변경 사항

  • =======: 두 변경 사항의 구분선

  • >>>>>>> origin/새시작: 원격 브랜치에서 가져온 변경 사항

실제 파일에서는 위 충돌 표시를 제거하고, 업무 요건을 확인하여 최종 코드를 결정해야 합니다.

예를 들어 timeout을 30초로 변경하기로 합의했다면 다음처럼 정리합니다.

int timeout = 30;

이후 충돌 해결 상태를 Git에 기록하고, 필요한 커밋을 완료한 다음 Push합니다.

주의: 충돌이 발생했다고 무조건 내 코드나 동료 코드를 선택하면 안 됩니다. 특히 거래 처리, 전문 통신, Redis 요청·응답, 타임아웃과 관련된 코드는 두 변경 사항의 목적을 확인해야 합니다.

4. Visual Studio 한글 버전에서 실제로 작업하는 방법

현재 사용 중인 APMKoreaClient 프로젝트 기준입니다. Visual Studio 버전에 따라 메뉴 이름이 조금 다를 수 있습니다.

권장 순서

1

원격 변경 사항 가져오기

상단 메뉴에서 Git → 가져오기(Fetch)를 실행합니다.

Git 리포지토리 창에서 origin/새시작에 새로운 커밋이 있는지 확인할 수 있습니다. Fetch는 내 소스 파일을 자동으로 변경하지 않습니다.

2

Pull로 변경 사항 통합하기

Git → 풀(Pull)을 실행합니다.

원격 변경 사항이 로컬에 통합됩니다. 로컬에 커밋하지 않은 수정 사항이 있다면 먼저 커밋하거나 안전하게 보관하고 진행하는 것이 좋습니다.

3

충돌이 발생하면 해결하기

Visual Studio의 Git 변경 내용 또는 Git 리포지토리 창에서 충돌 파일을 확인합니다.

충돌 파일을 열어 두 변경 사항을 비교하고, 최종 코드를 편집합니다. Visual Studio가 제공하는 병합 편집기를 이용해 로컬 변경, 원격 변경 또는 두 변경 사항을 조합할 수 있습니다.

4

충돌 해결 완료 후 커밋

충돌 파일을 저장하고 해결 완료 상태로 처리합니다. 필요한 병합 커밋을 완료한 후 빌드와 테스트를 진행합니다.

5

Push

Git 변경 내용 창에서 Push를 실행합니다. 로컬 변경 사항과 원격에서 받은 변경 사항이 통합된 이력이 GitLab의 새시작 브랜치에 반영됩니다.

참고: Visual Studio에서 Git Pull · Git 충돌 해결.

5. 작업 중인 소스가 있을 때 특히 주의할 점

Visual Studio에서 소스를 수정했지만 아직 커밋하지 않은 상태라면, Pull 전에 변경 사항부터 확인하세요.

  • 변경 사항이 중요하다면 우선 커밋하거나 Stash로 보관합니다.

  • Pull 후 내 수정 사항이 유지되었는지 확인합니다.

  • 충돌을 해결한 다음 빌드 및 테스트를 수행합니다.

  • 문제가 생겼다고 무조건 git reset --hard나 강제 Push를 사용하지 않습니다. 로컬 변경 사항이 사라지거나 원격 이력을 덮어쓸 수 있습니다.

6. 현재 프로젝트에 적합한 실무 절차

APMKoreaClient처럼 여러 모듈과 라이브러리로 구성된 프로젝트라면, 매번 다음 순서를 권장합니다.

시점작업
작업 시작 전 새시작 브랜치 확인 → Fetch → Pull
개발 중 소스 수정 → 빌드 및 테스트
반영 전 Git 변경 내용 확인 → Stage → Commit
반영 직전 다른 개발자의 새 커밋이 있는지 확인
Push 필요하면 Pull 및 충돌 해결 → Push
반영 후 GitLab에서 커밋 및 변경 파일 확인

팀에서 같은 파일을 동시에 수정하는 일이 많다면 작업 시작 전뿐 아니라 Push 직전에도 원격 변경 사항을 확인하는 것이 좋습니다.

핵심은 Fetch로 원격 변경 사항을 확인하고, Pull로 통합한 다음 Push하는 것입니다. 단, Pull이 항상 필수인 것은 아니며 원격 변경이 없거나 로컬이 이미 최신 상태라면 바로 Push할 수 있습니다.

참고로 Visual Studio 2022부터는 .NET Framework 4.0~4.5.1 타깃팅 구성 요소가 기본 제공되지 않으므로, 해당 프로젝트를 계속 빌드해야 한다면 VS 2017 또는 VS 2019를 사용하는 편이 적합합니다.


<?xml version="1.0" encoding="utf-8"?>
<Project ToolsVersion="4.0" DefaultTargets="Build" xmlns="http://schemas.microsoft.com/developer/msbuild/2003">
  <PropertyGroup>
    <Configuration Condition=" '$(Configuration)' == '' ">Debug</Configuration>
    <Platform Condition=" '$(Platform)' == '' ">x86</Platform>
    <ProductVersion>8.0.30703</ProductVersion>
    <SchemaVersion>2.0</SchemaVersion>
    <ProjectGuid>{518CD748-F620-487F-B75B-0E6DDA0CDFC0}</ProjectGuid>
    <OutputType>WinExe</OutputType>
    <AppDesignerFolder>Properties</AppDesignerFolder>
    <RootNamespace>APM</RootNamespace>
    <AssemblyName>APM</AssemblyName>
    <TargetFrameworkVersion>v4.0</TargetFrameworkVersion>

--------------------------------
--------------------------------
--------------------------------
--------------------------------
--------------------------------
--------------------------------
--------------------------------

제시하신 .csproj 프로젝트 파일은 Visual Studio 2017과 Visual Studio 2019 모두에서 열 수 있는 구형 C# 프로젝트 형식입니다. 핵심은 프로젝트 파일의 TargetFrameworkVersion이 v4.0으로 지정되어 있다는 점입니다.

1. Visual Studio 2017과 2019에서 열었을 때의 결과

<TargetFrameworkVersion>v4.0</TargetFrameworkVersion>

이 설정은 프로젝트가 .NET Framework 4.0을 대상으로 빌드되도록 지정합니다. Visual Studio 버전이 달라져도 이 값 자체가 자동으로 .NET Framework 4.7이나 4.8로 바뀌는 것은 아닙니다.

항목Visual Studio 2017Visual Studio 2019

프로젝트 열기 가능 가능
프로젝트 형식 구형 MSBuild 형식 구형 MSBuild 형식
대상 프레임워크 .NET Framework 4.0 .NET Framework 4.0
C# 소스 코드 동일한 코드 사용 가능 동일한 코드 사용 가능
빌드 결과물 APM.exe 또는 APM.dll APM.exe 또는 APM.dll
프레임워크 참조 .NET 4.0 참조 어셈블리 필요 .NET 4.0 참조 어셈블리 필요
디자이너 및 NuGet 구버전 호환성에 영향받음 구버전 호환성에 영향받음

단, 실제 빌드 성공 여부는 설치된 .NET Framework 타깃팅 팩, C# 컴파일러, NuGet 패키지 및 프로젝트의 나머지 설정에 따라 달라집니다.

2. 실제 차이가 발생하는 부분

① 프로젝트를 여는 것과 빌드하는 것은 다릅니다

Visual Studio에서 프로젝트 파일을 열 수 있어도 빌드가 성공한다는 의미는 아닙니다.

예를 들어 .NET Framework 4.0 참조 어셈블리가 설치되어 있지 않으면 다음과 같은 오류가 발생할 수 있습니다.

MSB3644: The reference assemblies for
.NETFramework,Version=v4.0 were not found.

이 경우에는 해당 버전의 참조 어셈블리 또는 타깃팅 팩을 설치해야 합니다.

GitHub+1

② Visual Studio 버전에 따른 차이

Visual Studio 2017

기존 .NET Framework 4.0 프로젝트를 유지하면서 소스 코드를 수정하고 빌드할 수 있습니다. 필요한 프레임워크 구성 요소가 설치되어 있어야 합니다.

Visual Studio 2019

마찬가지로 기존 프로젝트를 유지하고 빌드할 수 있습니다. 다만 VS 2017보다 최신 MSBuild 및 C# 컴파일러를 사용하므로 일부 구형 코드나 종속성에서 차이가 발생할 수 있습니다.

3. 프로젝트 파일의 각 설정 의미

설정의미
ToolsVersion="4.0" 구형 MSBuild 프로젝트 파일의 도구 버전 메타데이터
DefaultTargets="Build" 기본 빌드 대상은 Build
ProjectGuid 프로젝트를 식별하는 GUID
OutputType = WinExe 콘솔 창을 기본으로 띄우지 않는 Windows 실행 파일
RootNamespace = APM 기본 네임스페이스
AssemblyName = APM 생성되는 어셈블리 이름
TargetFrameworkVersion = v4.0 .NET Framework 4.0 대상

특히 ToolsVersion="4.0"과 TargetFrameworkVersion은 서로 다른 설정입니다. Visual Studio 2019에서 열었다고 해서 ToolsVersion을 반드시 16.0으로 변경할 필요는 없습니다.

4. 현재 APM 프로젝트에 권장하는 방법

기존 APM 소스를 그대로 유지하는 것이 목적이라면 다음 순서가 안전합니다.

  1. 원본 .csproj 파일을 백업합니다.

  2. Visual Studio 2017과 2019에서 각각 프로젝트를 엽니다.

  3. 프로젝트 속성의 응용 프로그램 → 대상 프레임워크에서 .NET Framework 4가 선택되어 있는지 확인합니다.

  4. Release 및 기존 플랫폼 설정으로 빌드합니다.

  5. 생성된 EXE/DLL과 참조 DLL을 비교합니다.

주의: 두 버전에서 같은 소스 코드를 빌드하더라도 컴파일러 버전, 빌드 옵션, 참조 라이브러리에 따라 결과 바이너리가 달라질 수 있습니다.

참고로 Visual Studio 2022부터는 .NET Framework 4.0~4.5.1 타깃팅 구성 요소가 기본 제공되지 않으므로, 해당 프로젝트를 계속 빌드해야 한다면 VS 2017 또는 VS 2019를 사용하는 편이 적합합니다.

레이블이 보이게 된 이유는 InvalidateRect()는 화면을 다시 그리도록 예약만 하고, UpdateWindow()는 그리기가 필요한 영역을 즉시 다시 그리도록 하기 때문입니다.

이번 문제는 파일명 설정이나 DrawText() 자체보다는 화면 갱신 시점의 문제였을 가능성이 높습니다.

기존 코드와 수정 코드의 차이

기존 코드

InvalidateRect(CRect(492, 174, 606, 234));

다시 그리기를 요청하지만, 실제 그리기는 나중에 처리될 수 있습니다.

수정 코드

CRect rcUpdate(492, 174, 606, 234);
InvalidateRect(&rcUpdate, FALSE);
UpdateWindow();

갱신할 영역이 있으면 UpdateWindow()에서 WM_PAINT 처리를 즉시 시도합니다.

왜 기존에는 레이블이 보이지 않았을까요?

로그를 보면 다음과 같았습니다.

  1. 프로그램 시작 시 OnPaint()가 실행됐지만 파일명은 빈 문자열이었습니다.

  2. 다운로드가 진행되면서 파일명이 0002_AMS.dll, 0003_AMS.pdb 등으로 정상 설정됐습니다.

  3. InvalidateRect()도 정상 호출됐지만, 이후 OnPaint() 로그는 나타나지 않았습니다.

  4. UpdateWindow()를 추가하자 레이블이 보였습니다.

따라서 기존에는 파일명 데이터가 준비된 뒤 해당 영역의 다시 그리기가 적절한 시점에 처리되지 않았던 것으로 보입니다.

최종 권장 코드

레이블이 정상적으로 표시된다면 우선 다음 형태로 사용하면 됩니다.

CRect rcUpdate(492, 174, 606, 234);

InvalidateRect(&rcUpdate, FALSE);
UpdateWindow();

다만 이 코드는 UI 스레드에서 실행되는 것이 전제입니다. 다운로드 처리 중 UI가 잠시 멈추거나 화면 갱신이 지나치게 자주 발생한다면, UpdateWindow()를 모든 처리 경로에 추가하기보다 필요한 위치에만 두는 것이 좋습니다.

참고로 InvalidateRect() 호출 후에도 OnPaint()가 실행되지 않았다는 로그만으로 메시지 처리 실패를 확정할 수는 없습니다. 이번 테스트에서 UpdateWindow()를 통해 즉시 그리기가 이루어졌다는 점이 핵심입니다.

질문)
with tbl_now_clock as ( select imf_nowclock-2 now_clock from dual ) tbl_now_clock은 테이블의 의미이고, now_clock은 필드의 의미인가요?

답변)

네, 개념적으로는 맞습니다. 다만 tbl_now_clock은 실제 데이터베이스 테이블이 아니라 CTE(Common Table Expression, 공통 테이블 표현식)의 이름입니다.

WITH tbl_now_clock AS (
    SELECT imf_nowclock - 2 AS now_clock
    FROM dual
)

각 요소의 의미는 다음과 같습니다.

구문의미설명
WITH CTE 정의 시작 임시 조회 결과를 정의
tbl_now_clock 테이블처럼 사용하는 이름 CTE 이름
SELECT 데이터 조회 계산할 값을 선택
imf_nowclock - 2 계산식 기준 시각에서 2를 뺀 값
AS now_clock 컬럼 이름 지정 계산 결과의 필드 이름
FROM dual 기준 데이터 Oracle의 DUAL 테이블에서 한 행을 조회

실행 결과를 개념적으로 표현하면 다음과 같습니다.

CTE: tbl_now_clock

컬럼명(필드명)

now_clock

컬럼에 들어가는 값

imf_nowclock - 2의 계산 결과

이후 다음과 같이 참조할 수 있습니다.

SELECT now_clock
FROM tbl_now_clock;

즉, tbl_now_clock은 테이블 역할을 하는 이름이고, now_clock은 그 안에 있는 컬럼(필드)의 이름입니다.

단, tbl_now_clock은 실제 테이블처럼 보이지만 이 SQL 문 안에서만 사용할 수 있는 조회 결과의 이름이며, 데이터베이스에 영구적으로 생성되는 테이블은 아닙니다.

현재 디렉터리에서 아래 명령어를 순서대로 실행해 보세요.

① 종료 코드 확인

APM.exe
echo ExitCode=%ERRORLEVEL%

종료 코드는 프로그램이 종료된 상태를 파악하는 단서입니다. 다만 종료 코드만으로 정확한 원인을 확정할 수는 없습니다.

② Windows 이벤트 로그에서 오류 확인

PowerShell을 열고 다음 명령어를 실행합니다.

Get-WinEvent -FilterHashtable @{
    LogName = 'Application'
    StartTime = (Get-Date).AddMinutes(-10)
} -ErrorAction SilentlyContinue |
Where-Object {
    $_.ProviderName -match 'Application Error|\.NET Runtime|Windows Error Reporting'
} |
Select-Object TimeCreated, ProviderName, Id, Message |
Format-List

Application Error 또는 .NET Runtime 관련 기록에 예외 유형, 오류가 발생한 모듈, DLL 이름 등이 표시될 수 있습니다.

4. 실행 실패 원인을 구분하는 기준

관찰 결과확인할 사항
.NET Runtime 오류 프로그램 내부 예외, 런타임 또는 종속성 문제
Application Error 모듈 충돌, 네이티브 DLL 오류 등
FileNotFoundException 필요한 DLL 또는 파일 누락
BadImageFormatException DLL의 아키텍처 또는 형식 불일치 가능성
오류 로그 없이 바로 종료 프로그램의 정상 종료 처리, 초기화 실패 후 종료 등


RedisClient 생성과 실제 TCP 연결 시점의 차이

조금 더 기술 문서답게 쓰면:

  • RedisClient 객체 생성과 TCP 연결(ESTABLISHED)의 관계
  • ServiceStack.Redis의 RedisClient 생성과 TCP 연결 시점
  • RedisClient Timeout 설정과 TCP 연결 상태의 관계
  • RedisClient 생성 → Redis 명령 실행 → TCP ESTABLISHED 흐름


네.
서로 다른 관점입니다. 그리고 지금 질문하신 부분이 정확히 핵심입니다.

두 코드를 구분하면 다음과 같습니다.

① new RedisClient(...)

_sendRedis = new RedisClient(ipAddress, Convert.ToInt32(portNo));

이것은 RedisClient 객체를 생성하는 것입니다.

즉,

"이 IP와 Port를 사용하는 Redis 연결 객체를 준비한다."

는 의미입니다.

이 코드만 보고 TCP 연결이 이미 ESTABLISHED 되었다고 단정하면 안 됩니다.


② SendTimeout, RetryTimeout

_sendRedis.SendTimeout = 10 * 60 * 1000;
_sendRedis.RetryTimeout = 10 * 60 * 1000;

이것은 TCP 연결을 만드는 코드가 아닙니다.

단순히 RedisClient의 동작에 사용할 timeout 값을 설정합니다.

즉:

new RedisClient()
        ↓
RedisClient 객체 생성
        ↓
SendTimeout 설정
RetryTimeout 설정
        ↓
아직 실제 TCP 연결이 없을 수도 있음

입니다.


③ 실제 TCP 연결이 만들어지는 시점

그 다음에 실행되는:

_sendWorker.RunWorkerAsync();

에서 sendWorker_DoWork()가 실행되고, 그 안에서 실제 Redis 명령을 수행할 때 TCP 연결이 필요해집니다.

예를 들어:

private void sendWorker_DoWork(...)
{
    _sendRedis.Set(...);
}

라면 Set() 같은 Redis 명령을 수행하기 위해 TCP 연결이 필요합니다.

그때:

C# 프로그램
   │
   │ TCP Connect
   ▼
10.112.160.71:9111
   │
   ▼
ESTABLISHED

가 될 수 있습니다.


그런데 여기서 중요한 예외가 하나 있습니다

제가 앞에서 **"new RedisClient만으로는 TCP 연결이 없을 수도 있다"**라고 말씀드렸는데, 이것은 ServiceStack.Redis의 버전/구현에 따라 실제 연결 시점이 다를 수 있기 때문에 그렇게 표현한 것입니다.

따라서 현재 사용 중인 ServiceStack.Redis 버전의 RedisClient 구현을 정확히 확인하면 더 확실하게 말할 수 있습니다.

하지만 현재 코드의 논리적인 구분은 명확합니다.

코드역할netstat와 직접 관계
new RedisClient(ip, port) RedisClient 객체 생성 TCP 연결을 단정할 수 없음
SendTimeout = ... 송신 timeout 설정 TCP 연결 생성과 무관
RetryTimeout = ... 재시도 관련 timeout 설정 TCP 연결 생성과 무관
Redis 명령 실행 실제 Redis 통신 TCP 연결이 필요
TCP 연결 유지 OS가 관리 ESTABLISHED로 표시

그리고 질문하신 10분 설정은 특히 중요합니다

예를 들어:

_sendRedis.SendTimeout = 10 * 60 * 1000;

은

10분 동안 netstat에서 연결을 유지한다

라는 의미가 아닙니다.

또한

10분이 지나야 ESTABLISHED가 나타난다

도 아닙니다.

이 설정은 Redis 명령을 수행하는 과정에서 timeout을 얼마나 기다릴지와 관련된 설정입니다.


따라서 현재 상황을 이렇게 이해하시면 정확합니다.

Init()
 │
 ├─ new RedisClient()
 │       │
 │       └─ RedisClient 객체 준비
 │
 ├─ SendTimeout = 10분
 │
 ├─ RetryTimeout = 10분
 │
 └─ RunWorkerAsync()
          │
          ▼
    sendWorker_DoWork()
          │
          ▼
    실제 Redis 명령
          │
          ▼
    TCP 연결 필요
          │
          ▼
    ESTABLISHED

그래서 SendTimeout = 10분 때문에 netstat에 안 보이는 것은 아닙니다.


그리고 지금 올려주신 코드에서는 제가 한 가지를 더 중요하게 보고 있습니다.

_sendWorker.RunWorkerAsync();

바로 이 부분입니다.

sendWorker_DoWork() 안에서 Redis를 어떻게 사용하고 있는지를 보면 _sendRedis의 TCP 연결이 언제 만들어지는지 거의 확정할 수 있습니다.

sendWorker_DoWork()와 recvWorker_DoWork() 두 개를 올려주시면, 각각 netstat에 몇 개가 보여야 하는지까지 실제 코드 흐름으로 계산해드릴 수 있습니다.

APM 시스템 기술 아키텍처 소개

1. Agent — C 기반 모니터링 데이터 수집 Agent

APM Agent는 대상 시스템에 설치되어 시스템 및 애플리케이션의 성능 데이터를 실시간으로 수집하고, 수집된 데이터를 중앙 수집 서버로 전송하는 경량형 모니터링 모듈이다.

Agent는 C 언어 기반의 Native Application으로 구현되며, 서버 시스템에 상주하면서 주기적인 Polling 또는 Event 기반 수집 방식을 통해 모니터링 데이터를 획득한다.

1.1 수집 대상

Agent에서 수집하는 주요 모니터링 대상은 다음과 같다.

구분주요 수집 데이터
System CPU, Memory, Disk, Network, Load Average, 시스템 자원 사용률
DBMS Session, Connection, Transaction, SQL 수행정보, Lock, Buffer/Cache, DB Resource
Middleware Connection Pool, Queue, Thread, Transaction, 처리량, 응답시간
Process Process CPU, Memory, Thread, Process 상태, Process 수
Application Transaction, TPS, 응답시간, 오류율, Application Resource, 사용자 요청 정보

Agent는 수집 대상별 Collector 또는 Monitor Module을 통해 데이터를 수집하고, 내부적으로 수집 데이터를 표준 데이터 구조로 변환 및 정규화(Normalization) 한다.

1.2 데이터 전송

수집된 데이터는 Agent에서 중앙 수집 서버로 직접 TCP 통신하는 방식이 아니라 Redis를 Message Transport Layer로 활용하여 비동기 방식으로 전송한다.

[System / DBMS / Middleware / Process / Application]
                         │
                         ▼
                ┌─────────────────┐
                │   APM Agent     │
                │   C 기반        │
                │   Collector     │
                └────────┬────────┘
                         │
                    JSON Serialize
                         │
                         ▼
                ┌─────────────────┐
                │      Redis      │
                │ Message Transport│
                └────────┬────────┘
                         │
                         ▼
                   APM Server
 

데이터 전송 포맷은 JSON(JavaScript Object Notation) 을 사용한다.

즉, Agent에서 수집된 Monitoring Data를 JSON 형태로 Serialization한 후 Redis에 전달하고, 서버에서는 Redis로부터 데이터를 수신하여 Deserialization 후 내부 데이터 구조로 변환한다.

1.3 주요 기술적 특징

  • C 기반 Native Agent
  • 저오버헤드(Low Overhead) 데이터 수집
  • 실시간/주기적 모니터링
  • Monitoring Data Collector 구조
  • JSON 기반 Data Serialization
  • Redis 기반 Message Transport
  • 비동기 데이터 전송 구조
  • 수집 대상별 Collector 모듈화
  • Agent와 Server 간 Loose Coupling


2. APM Server — 데이터 수집 및 서비스 Server

APM Server는 Agent와 Client 사이에서 Monitoring Data의 수집, 저장, 조회 및 전달을 담당하는 중앙 처리 서버이다.

Server는 C 언어 기반으로 구성되며 크게 Agent 대응 영역과 Client 대응 영역으로 구분할 수 있다.


2.1 Agent 대응 — Monitoring Data 수집 및 저장

Agent에서 Redis를 통해 전달한 JSON 데이터를 Server가 수신한다.

Agent
  │
  │ JSON
  ▼
Redis
  │
  ▼
┌───────────────────────────┐
│       APM Server           │
│                           │
│  Redis Receiver           │
│       │                   │
│       ▼                   │
│  JSON Parser              │
│       │                   │
│       ▼                   │
│  Data Validation           │
│       │                   │
│       ▼                   │
│  Data Normalization        │
│       │                   │
│       ├──────────► DB      │
│       │                    │
│       └──────────► Shared  │
│                    Memory  │
└───────────────────────────┘
 

Server는 Redis를 통해 Agent가 전달한 데이터를 수신하고 다음과 같은 처리 과정을 수행한다.

Redis Receive → JSON Parsing → Validation → Data Processing → Storage

수신 데이터는 실시간 조회가 필요한 데이터와 장기 보관이 필요한 데이터로 구분하여 처리한다.

Shared Memory

실시간 모니터링 화면에서 빠르게 조회해야 하는 데이터는 Shared Memory 기반의 In-Memory Data Store에 저장한다.

Shared Memory를 사용하는 목적은 DB I/O를 최소화하고 Client의 반복적인 조회 요청에 대해 Low Latency 데이터 제공을 하기 위함이다.

Database

장기적인 데이터 보관이 필요한 Monitoring Data는 Database에 저장한다.

Database에는 다음과 같은 용도의 데이터가 저장될 수 있다.

  • Historical Monitoring Data
  • Performance Statistics
  • Transaction History
  • 장애 및 Event 정보
  • 사용자 조회 이력
  • 통계 및 분석 데이터

따라서 서버의 저장 구조는 다음과 같이 구성된다.

                    ┌───────────────┐
                    │  APM Server   │
                    └───────┬───────┘
                            │
                 ┌──────────┴──────────┐
                 │                     │
                 ▼                     ▼
          ┌─────────────┐       ┌─────────────┐
          │ Shared      │       │ Database    │
          │ Memory      │       │             │
          │             │       │ Historical  │
          │ Real-Time   │       │ Data        │
          │ Data        │       │             │
          └─────────────┘       └─────────────┘
 

즉,

Shared Memory = 실시간 데이터 처리 및 조회 최적화

Database = 장기 데이터 저장 및 이력/통계 조회

라는 역할 분담을 갖는다.


2.2 Client 대응 — Monitoring Data 제공

APM Client가 특정 Monitoring Data를 요청하면 Server는 요청 내용을 분석하여 Shared Memory 또는 Database에서 필요한 데이터를 조회한다.

APM Client
    │
    │ Request
    ▼
 Redis
    │
    ▼
APM Server
    │
    ├────► Shared Memory
    │
    └────► Database
              │
              ▼
        Query / Data Processing
              │
              ▼
          JSON Serialize
              │
              ▼
            Redis
              │
              ▼
          APM Client
 

Client의 요청에 따라 Server는 다음과 같은 처리를 수행한다.

  1. Client Request 수신
  2. Request Message Parsing
  3. 요청 대상 및 조회 조건 분석
  4. Shared Memory 또는 Database 조회
  5. 데이터 가공 및 Aggregation
  6. JSON Serialization
  7. Redis를 통한 Client 전송

특히 실시간 Dashboard의 경우 Shared Memory를 우선적으로 활용하여 빠른 응답시간과 높은 처리량(Throughput) 을 확보할 수 있다.


2.3 Server의 핵심 역할

APM Server는 단순한 데이터 중계 역할이 아니라 다음과 같은 기능을 수행하는 Central Monitoring Data Processing Layer이다.

  • Agent Data 수집
  • JSON Parsing / Serialization
  • Data Validation
  • Data Normalization
  • Real-Time Data Management
  • Shared Memory Management
  • Historical Data Persistence
  • Monitoring Data Query
  • Data Aggregation
  • Client Request Processing
  • Redis Message Processing
  • Agent/Client 간 데이터 중계

따라서 전체 시스템에서 Server는 Data Collection Layer와 Presentation Layer를 연결하는 Core Processing Layer의 역할을 수행한다.


3. APM Client — C# 기반 Monitoring Console

APM Client는 최종 사용자가 시스템의 상태와 성능을 확인하기 위한 Monitoring Console / Visualization Layer이다.

C# 기반의 Windows Desktop Application으로 구현하며, WinForms MDI(Multiple Document Interface) Architecture를 기반으로 여러 모니터링 화면을 하나의 Main Application에서 관리한다.


3.1 데이터 요청 및 수신 구조

Client는 사용자가 화면을 실행하거나 Monitoring 화면을 활성화하면 필요한 데이터를 Server에 요청한다.

┌──────────────────────────────┐
│        APM Client            │
│          C# / WinForms       │
│                              │
│  ┌──────┐ ┌──────┐ ┌──────┐ │
│  │화면1 │ │화면2 │ │화면3 │ │
│  │Dash  │ │Grid  │ │Chart │ │
│  └──┬───┘ └──┬───┘ └──┬───┘ │
│     └────────┼────────┘      │
│              ▼               │
│        Request Manager       │
└──────────────┬───────────────┘
               │
               ▼
             Redis
               │
               ▼
           APM Server
 

Client에서 발생한 요청은 JSON으로 Serialization하여 Redis를 통해 Server에 전달한다.

Server의 응답 역시 JSON 형태로 전달되며 Client에서는 이를 Parsing하여 해당 화면에서 사용할 수 있는 데이터 모델로 변환한다.


3.2 Push / Pop 기반 데이터 처리

Client와 Server 사이의 데이터 교환은 Redis를 Transport Layer로 사용한다.

개념적으로 다음과 같은 구조를 가진다.

Client
  │
  │ Push Request
  ▼
Redis
  │
  ▼
Server
  │
  │ Data Processing
  ▼
Redis
  │
  │ Pop Response
  ▼
Client
 

Client에서는 화면별 요청을 생성하고 Redis를 통해 Server에 전달한다.

Server에서 처리된 결과는 다시 Redis를 통해 Client로 전달되며, Client는 수신 데이터를 해당 화면에 전달한다.

이를 Message-based Asynchronous Communication Architecture로 볼 수 있다.


3.3 MDI 기반 Monitoring 화면

Client는 하나의 Main Form에서 여러 Monitoring 화면을 Child Form으로 관리하는 MDI Architecture를 사용한다.

예를 들어 다음과 같은 화면을 동시에 운영할 수 있다.

APM Main Client
│
├── System Monitoring
│
├── DBMS Monitoring
│
├── Middleware Monitoring
│
├── Process Monitoring
│
├── Application Monitoring
│
├── Transaction Monitoring
│
├── Performance Dashboard
│
└── Statistics / Analysis
 

각 화면은 독립적으로 Server에 데이터를 요청하고, 수신된 데이터를 해당 화면의 Visualization Component를 통해 표현한다.


3.4 Monitoring Data Visualization

Client에서 제공하는 주요 데이터 표현 방식은 다음과 같다.

Dashboard

시스템 전체 상태를 한눈에 파악할 수 있도록 주요 성능지표를 KPI(Key Performance Indicator) 형태로 표현한다.

예:

  • CPU Usage
  • Memory Usage
  • TPS
  • Response Time
  • Error Count
  • Active Session
  • Process Count
  • Queue Size

Grid

대량의 Monitoring Data 또는 상세 데이터를 Tabular Data 형태로 표시한다.

예:

  • Process List
  • Transaction List
  • SQL List
  • Application Request List
  • 장애/Event List

Chart

시간에 따른 성능 변화를 시각화한다.

예:

  • CPU Trend
  • Memory Trend
  • TPS Trend
  • Response Time Trend
  • Transaction Trend
  • Error Trend

이를 통해 사용자는 현재 상태뿐만 아니라 Time-Series 기반의 Performance Trend를 분석할 수 있다.


전체 시스템 아키텍처

전체적으로 APM 시스템은 다음과 같은 3-Tier / Layered Architecture 형태로 구성할 수 있다.

┌─────────────────────────────────────────────────────────┐
│                    APM CLIENT                           │
│                  C# / WinForms                         │
│                                                         │
│  Dashboard │ Grid │ Chart │ Monitoring │ Statistics    │
│                         │                               │
│                  Request / Response                     │
└─────────────────────────┬───────────────────────────────┘
                          │
                          │ JSON
                          │ Redis
                          ▼
┌─────────────────────────────────────────────────────────┐
│                    APM SERVER                           │
│                       C                                 │
│                                                         │
│  Agent Receiver                                         │
│       │                                                 │
│       ├── JSON Parser                                   │
│       ├── Data Validation                               │
│       ├── Data Processing                               │
│       ├── Data Aggregation                              │
│       │                                                 │
│       ├──────────────► Shared Memory                    │
│       │                 (Real-Time Data)                │
│       │                                                 │
│       └──────────────► Database                         │
│                         (Historical Data)               │
│                                                         │
│                  Client Request Handler                  │
└─────────────────────────┬───────────────────────────────┘
                          │
                          │ JSON
                          │ Redis
                          ▼
┌─────────────────────────────────────────────────────────┐
│                    APM AGENT                            │
│                       C                                 │
│                                                         │
│  System Collector                                      │
│  DBMS Collector                                        │
│  Middleware Collector                                  │
│  Process Collector                                     │
│  Application Collector                                 │
│                                                         │
│                Monitoring Data Collection                │
└─────────────────────────────────────────────────────────┘
 

기술 구성 요약

구분AgentServerClient
역할 데이터 수집 데이터 수집/처리/저장/제공 데이터 요청/표현
개발언어 C C C#
주요 기능 Monitoring Data Collection Data Processing & Management Visualization
통신 Redis Redis Redis
데이터 포맷 JSON JSON JSON
실시간 데이터 수집 Shared Memory Dashboard/Grid/Chart
이력 데이터 - Database Statistics/Analysis
구조 Collector Processing Layer Presentation Layer
통신방식 Message-based Message-based Message-based
주요 특징 Low Overhead High Throughput / Low Latency Rich Visualization

한 문장으로 정리하면

APM 시스템은 C 기반 Agent가 System/DBMS/Middleware/Process/Application의 성능 데이터를 수집하고, Redis/JSON 기반의 Message-Oriented Communication을 통해 C 기반 Server로 전달하며, Server는 Shared Memory와 Database를 이용하여 실시간 및 이력 데이터를 관리하고, C# 기반 Client가 이를 요청하여 Dashboard, Grid, Chart 등의 형태로 시각화하는 3-Tier Monitoring Architecture로 구성된다.

1. Kotlin이란?

Kotlin은 프로그래밍 언어입니다.

가장 쉽게 말하면:

Java와 매우 호환성이 좋은 현대적인 언어
 

입니다.

Kotlin 코드는 주로 JVM(Java Virtual Machine) 위에서 실행됩니다.

Kotlin
   ↓ 컴파일
JVM Bytecode
   ↓
JVM
 

따라서 Java와 Kotlin은 서로 매우 밀접한 관계입니다.


2. Java와 Kotlin 관계

예를 들어 Java:

 
public class Hello {
    public static void main(String[] args) {
        System.out.println("Hello");
    }
}
 

Kotlin:

 
fun main() {
    println("Hello")
}
 

Kotlin은 Java보다 비교적 간결하게 작성할 수 있습니다.

그리고 중요한 특징은:

Java Library
       ↕
Kotlin
 

호환성이 매우 좋다는 것입니다.

예를 들어 기존 Java 라이브러리를 Kotlin에서 사용할 수 있습니다.


3. 왜 Backend Server에 Kotlin을 사용할 수 있나?

Backend Server는 다음 역할을 합니다.

Browser
   ↓
HTTP / REST API
   ↓
Backend Server
   ↓
Redis / DB
 

이 Backend를 Java로 만들 수도 있습니다.

Java
+
Spring Boot
 

그런데 Kotlin으로도 만들 수 있습니다.

Kotlin
+
Spring Boot
 

즉:

Java Backend
 

와

Kotlin Backend
 

는 거의 같은 영역에서 경쟁하는 선택지입니다.

예

방식 1

Java
+
Spring Boot
 

또는

방식 2

Kotlin
+
Spring Boot
 

따라서 이전에 제가 작성한:

Backend Server 또는 Android Agent

라는 의미는 다음과 같습니다.

Kotlin을 Backend Server 개발 언어로 사용할 수 있다.
또는
Android Agent 개발 언어로 사용할 수 있다.
 

입니다.


4. Android Agent에 사용하는 이유

현재 Android 개발에서는 Kotlin이 매우 많이 사용됩니다.

예를 들어:

Android Application
       │
       ├─ CPU 정보
       ├─ Memory 정보
       ├─ Network 정보
       └─ Application 정보
               │
               ▼
            APM Server
 

APM Agent가 Android Application 안에 들어간다면 Kotlin을 사용할 수 있습니다.

Android App
    │
    ├─ Kotlin
    │
    └─ APM Agent
           │
           ▼
       APM Server
 

예를 들어:

 
fun sendMetric(cpu: Double, memory: Double) {

    // APM 서버에 데이터 전송
}
 

같은 형태입니다.


5. 그런데 현재 APM에서는 Kotlin이 꼭 필요한가?

아닙니다.

현재 말씀하신 환경에서는 Kotlin이 꼭 필요하지 않을 가능성이 큽니다.

현재 사용하시는 APM을 보면:

C Server
↓
Redis
↓
C# WinForms Client
 

입니다.

이를 Web 구조로 변경한다면:

C Server
↓
Redis
↓
Java Backend
↓
TypeScript Frontend
 

이면 충분합니다.

즉:

C
Java
TypeScript
HTML/CSS
 

만으로 구축 가능합니다.


6. Kotlin은 언제 사용하는 것이 좋은가?

Kotlin을 사용하는 대표적인 경우입니다.

① Android APM Agent

Android Application
       ↓
Kotlin APM Agent
       ↓
APM Server
 

가장 자연스러운 사용 사례입니다.


② Java 대신 Backend 개발

Java Spring Boot
 

대신:

Kotlin Spring Boot
 

를 사용할 수 있습니다.

하지만:

Java + Kotlin
 

을 굳이 동시에 사용할 필요는 없습니다.

예를 들어:

❌ 복잡할 수 있는 구조

Java Backend
+
Kotlin Backend
 

보다는

⭕ 하나를 선택

Java Backend
 

또는

Kotlin Backend
 

가 관리하기 쉽습니다.


7. 현재 APM에 대한 제 의견

사용자님은 현재:

  • C
  • C#
  • WinForms
  • Redis
  • TCP
  • APM

경험이 많으시므로, 새로운 APM을 만든다면 저는 다음을 추천합니다.

┌──────────────────────┐
│ APM Agent            │
│                      │
│ C / Java             │
└──────────┬───────────┘
           │
           ▼
┌──────────────────────┐
│ APM Collector        │
│                      │
│ C                    │
└──────────┬───────────┘
           │
           ▼
         Redis
           │
           ▼
┌──────────────────────┐
│ Backend API          │
│                      │
│ Java + Spring Boot   │
└──────────┬───────────┘
           │
     REST / WebSocket
           │
           ▼
┌──────────────────────┐
│ Web Client           │
│                      │
│ TypeScript + React   │
│ HTML + CSS           │
└──────────────────────┘
 

핵심 정리

기술현재 APM에서의 추천도
C ⭐⭐⭐⭐⭐ Agent / Collector
Java ⭐⭐⭐⭐⭐ Backend
Kotlin ⭐⭐ Java 대체 또는 Android
TypeScript ⭐⭐⭐⭐⭐ Web Client
HTML/CSS ⭐⭐⭐⭐⭐ Web 화면

따라서 현재 PC/서버 APM을 Web 기반으로 전환하는 목적이라면 Kotlin은 필수 기술이 아닙니다.

Kotlin은 Java Backend를 Kotlin으로 개발하고 싶거나, Android용 APM Agent를 개발할 때 의미가 큰 기술이라고 이해하시면 가장 정확합니다.

질문)
APM 구축시에 기존기술 : 서버 c, 클라이언트 c# 일 경우에 아래의 변경기술로 전환시에 어떤 변경사항이 있을까요? 서버는 비슷할것 같고, 클라이언트는 어떻게 구축하는것이 바람직할까요? 아래의 기술을 통해서 변경기술 : C, Java, Kotlin, TypeScript, HTML/CSS

답변)

현재

C Server
   ↓
Redis
   ↓
C# WinForms


변경

C Server
   ↓
Redis
   ↓
Java API Server
   ↓
WebSocket / REST
   ↓
TypeScript + React


APM을 C 서버 + C# WinForms 클라이언트
형태로 구축하고 계신 상황이라면,

변경 기술: C, Java, Kotlin, TypeScript, HTML/CSS

로 전환할 때 가장 중요한 변화는 서버보다 클라이언트 아키텍처가 크게 바뀐다는 것입니다.

결론부터 말씀드리면 저는 다음 구조를 가장 권장합니다.

┌──────────────────────────────────────────────┐
│                  APM Agent                   │
│                                              │
│ C / Java / Kotlin 등의 서비스                │
└──────────────────┬───────────────────────────┘
                   │ TCP / HTTP / gRPC
                   ▼
┌──────────────────────────────────────────────┐
│                 APM Server                   │
│                                              │
│ C 기반 기존 수집 서버                        │
│ 또는 Java 기반 Backend                       │
│                                              │
│ 데이터 수집 / 집계 / 분석 / 저장             │
└──────────────────┬───────────────────────────┘
                   │ REST API / WebSocket
                   ▼
┌──────────────────────────────────────────────┐
│              Web APM Client                  │
│                                              │
│ TypeScript + React 또는 Vue                  │
│ HTML / CSS                                   │
└──────────────────────────────────────────────┘
                   │
                   ▼
             Chrome / Edge
 

1. 기존 구조

현재 구조를 단순화하면 아마 이런 형태에 가깝습니다.

[C APM Server]
       │
       │ TCP / Redis / 자체 Protocol
       ▼
[C# WinForms Client]
       │
       ├─ DataGridView
       ├─ TreeView
       ├─ ScottPlot
       └─ 각종 화면
 

예를 들어 현재 작업하셨던 구조처럼:

C Server
   ↓
Redis
   ↓
C# Client
   ↓
DataGridView / TreeView / Chart
 

입니다.


2. 변경 후 가장 큰 변화

변경 기술에:

C
Java
Kotlin
TypeScript
HTML/CSS
 

가 들어간다면 자연스럽게 다음과 같이 역할을 나누는 것이 좋습니다.

기술권장 역할
C APM Agent / 기존 Server / 고성능 수집
Java Backend Server
Kotlin Backend Server 또는 Android Agent
TypeScript Web Frontend
HTML 화면 구조
CSS 화면 디자인

즉,

C# WinForms Client
 

가 없어지고,

TypeScript Web Client
 

로 변경되는 것이 가장 자연스럽습니다.


3. 서버는 기존 C를 유지할 수 있나?

네. 가능합니다.

오히려 현재 APM 서버가 이미 안정적으로 동작하고 있다면 굳이 C 서버 전체를 Java로 다시 만들 필요는 없습니다.

예:

┌────────────────────┐
│ 기존 C APM Server   │
│                    │
│ TCP 수신           │
│ 데이터 분석        │
│ Redis              │
└─────────┬──────────┘
          │
          │ HTTP API
          ▼
┌────────────────────┐
│ Java API Server    │
│                    │
│ REST API           │
│ WebSocket          │
└─────────┬──────────┘
          │
          ▼
     Web Browser
 

이 구조가 현실적인 점진적 전환 방법입니다.


4. 가장 권장하는 전체 구조

제가 현재 사용하시는 APM 구조를 고려하면 다음을 추천합니다.

                    APM AGENT

     C Agent       Java Agent       Kotlin Agent
        │               │               │
        └───────────────┼───────────────┘
                        │
                        ▼
              ┌─────────────────┐
              │   C Collector   │
              │                 │
              │ TCP Server      │
              │ Queue           │
              │ Parser          │
              └────────┬────────┘
                       │
                       ▼
                 Redis / DB
                       │
                       ▼
              ┌─────────────────┐
              │ Java Backend    │
              │                 │
              │ REST API        │
              │ WebSocket       │
              │ Authentication  │
              └────────┬────────┘
                       │
                       ▼
              ┌─────────────────┐
              │ Web Frontend    │
              │                 │
              │ TypeScript      │
              │ React/Vue       │
              │ HTML/CSS        │
              └─────────────────┘
 

5. 왜 C# WinForms 대신 TypeScript Web인가?

현재 C# WinForms는 다음과 같은 구조입니다.

 
DataGridView
TreeView
FormsPlot
Timer
Invoke()
 

Web에서는 이렇게 변경됩니다.

WinFormsWeb
DataGridView AG Grid / Data Grid
TreeView Tree Component
ScottPlot ECharts / Chart.js
Timer setInterval
Invoke() 필요 없음
Form Page
UserControl Component
EventHandler Event
Thread async / Promise

6. 현재 APM 화면을 Web로 변경하면

예를 들어 현재:

APMMain
 ├─ 서버 목록
 ├─ TreeView
 ├─ Grid
 ├─ CPU
 ├─ Memory
 ├─ TPS
 └─ Response Time Chart
 

라면 Web에서는:

APM Dashboard
│
├── Header
│
├── Left Menu
│
├── Server Tree
│
├── Server List Grid
│
├── CPU Chart
│
├── Memory Chart
│
└── Transaction Chart
 

이런 Component 구조가 됩니다.

App
│
├── Header
│
├── Sidebar
│
├── ServerTree
│
├── ServerGrid
│
├── CpuChart
│
├── MemoryChart
│
└── TransactionChart
 

7. TypeScript Framework는 무엇이 좋을까?

제가 가장 추천하는 것은 React입니다

TypeScript
+
React
 

구조입니다.

React
 ├── Component 구조
 ├── TypeScript
 ├── WebSocket
 ├── REST API
 └── 다양한 Chart/Grid Library
 

APM 화면은 일반 홈페이지보다:

  • 실시간 데이터
  • 많은 Grid
  • Chart
  • Tree
  • Dashboard
  • WebSocket

비중이 높습니다.

따라서 React가 상당히 적합합니다.


8. APM Client의 실시간 통신

현재 C#에서는 아마 이런 구조가 있을 것입니다.

Timer
   ↓
Redis 요청
   ↓
결과 수신
   ↓
Display()
 

예:

 
private void Display(PWInterface ifReceive)
{
    ...
}
 

Web에서는 크게 두 가지 방법이 있습니다.


방법 1. Polling

Browser
   │
   │ 1초마다 REST API
   ▼
Java Backend
   │
   ▼
Redis
 

TypeScript:

 
setInterval(async () => {

    const response =
        await fetch("/api/server/list");

    const data =
        await response.json();

    updateGrid(data);

}, 1000);
 

장점

  • 구현 쉬움
  • 기존 구조와 유사

단점

APM 서버가 많으면:

Client 100명

100명 × 1초
 

계속 요청이 발생합니다.


9. APM에는 WebSocket을 더 권장

APM은 실시간 화면이 많으므로:

WebSocket
 

이 더 적합합니다.

Browser
   │
   │ WebSocket 연결
   ▼
Java Backend
   │
   │ Redis Subscribe
   ▼
Redis
 

데이터가 발생하면:

APM Data 발생
      ↓
Redis
      ↓
Java Backend
      ↓
WebSocket
      ↓
Browser
      ↓
React 화면 Update
 

이 구조입니다.


10. 현재 C# Invoke()는 없어집니다

현재 WinForms에서는:

 
treeview.Invoke(new MethodInvoker(delegate
{
    ...
}));
 

가 필요합니다.

왜냐하면:

Worker Thread
       ↓
UI Thread
 

가 분리되어 있기 때문입니다.

React에서는 일반적으로:

 
setState(data);
 

처럼 상태를 변경하면 됩니다.

예:

 
const [servers, setServers] =
    useState<Server[]>([]);

webSocket.onmessage = (event) => {

    const data =
        JSON.parse(event.data);

    setServers(data);
};
 

React가 화면을 다시 렌더링합니다.

즉 현재의:

Invoke
BeginInvoke
MethodInvoker
 

개념이 상당 부분 없어집니다.


11. Java와 Kotlin은 둘 다 Backend에 필요한가?

개인적으로는 둘 다 사용할 필요는 없습니다.

예를 들어:

C
Java
Kotlin
TypeScript
HTML/CSS
 

라고 해서 모든 기술을 반드시 동시에 Backend에 사용할 필요는 없습니다.

저라면:

C          → APM Agent / Collector
Java       → Backend API
TypeScript → Frontend
HTML/CSS   → UI
 

를 사용합니다.

즉:

C + Java + TypeScript
 

중심입니다.

Kotlin은 필요하면:

Java Backend
 

대신 선택할 수 있습니다.

Java 또는 Kotlin
 

이라고 보는 것이 좋습니다.


12. 제가 가장 추천하는 실제 구성

Agent

C
Java
Kotlin
 

각 시스템의 Agent.


Collector

C
 

기존 서버를 최대한 유지.

C Collector
    ↓
Redis
 

Backend

Java
Spring Boot
 

역할:

REST API
WebSocket
로그인
권한관리
Redis 접근
DB 접근
 

Frontend

TypeScript
React
HTML
CSS
 

역할:

APM Dashboard
Grid
Tree
Chart
Monitoring
 

최종 권장 구조

┌──────────────────────────────────────┐
│              APM AGENT               │
│                                      │
│   C / Java / Kotlin                  │
└──────────────────┬───────────────────┘
                   │
                   │ TCP
                   ▼
┌──────────────────────────────────────┐
│             C COLLECTOR              │
│                                      │
│ 기존 APM Server                      │
│ Parser                               │
│ Queue                                │
└──────────────────┬───────────────────┘
                   │
                   ▼
              Redis / DB
                   │
                   ▼
┌──────────────────────────────────────┐
│           JAVA BACKEND               │
│                                      │
│ Spring Boot                          │
│ REST API                             │
│ WebSocket                            │
│ Authentication                       │
└──────────────────┬───────────────────┘
                   │
                   ▼
┌──────────────────────────────────────┐
│          TYPESCRIPT FRONTEND         │
│                                      │
│ React                                │
│ Grid                                 │
│ Tree                                 │
│ Chart                                │
│ Dashboard                            │
└──────────────────────────────────────┘
 

핵심 결론

현재 사용 중인 APM이 이미 C Server + Redis + C# WinForms 구조라면, 저는 서버를 전부 다시 개발하지 않고 다음처럼 단계적으로 전환하는 것이 가장 현실적이라고 봅니다.

현재

C Server
   ↓
Redis
   ↓
C# WinForms


변경

C Server
   ↓
Redis
   ↓
Java API Server
   ↓
WebSocket / REST
   ↓
TypeScript + React
 

즉, 가장 큰 변경 대상은 C# WinForms Client이고, 이것을 TypeScript 기반 Web APM Client로 재구축하는 것이 바람직합니다.

질문)
Win Form 안에 폰트를 가진 컨트롤이 여러개 있을떄에 폰트를 설정하지 않았을경우에, 어떤 폰트를 가지게 되나요?

답변)

WinForms에서는 컨트롤마다 폰트를 따로 지정하지 않았다고 해서 폰트가 없는 상태가 되는 것은 아닙니다. 기본적으로 부모 컨트롤의 Font를 상속(inherit) 받습니다.

예를 들어

 
Form
 ├─ Panel
 │   ├─ Label1
 │   ├─ Label2
 │   └─ Button1
 └─ TextBox1
 

Form의 폰트를:

 
this.Font = new Font("맑은 고딕", 12F);
 

로 지정하고 각각의 컨트롤에는 Font를 지정하지 않았다면:

Form
 ↓
맑은 고딕 12
 ↓
Panel
 ↓
Label1     → 맑은 고딕 12
Label2     → 맑은 고딕 12
Button1    → 맑은 고딕 12
 

처럼 부모의 Font를 물려받습니다.


그런데 중요한 부분이 있습니다

WinForms 컨트롤의 Font 속성을 보면 보통 디자이너에서:

Font = [System.Drawing.Font]
 

처럼 보이더라도 실제로는 Control.Font가 Ambient Property(주변 속성) 방식으로 부모에게서 값을 상속받을 수 있습니다.

즉:

 
label1.Font
 

을 호출했을 때 반드시

"Label 자체에 저장된 Font"

를 의미하는 것은 아닙니다.

부모로부터 상속받은 최종 Font가 반환될 수 있습니다.


그럼 Form에도 Font를 설정하지 않았다면?

여기가 질문의 핵심일 것 같습니다.

예를 들어:

 
public Form1()
{
    InitializeComponent();
}
 

이고

 
this.Font
 

도 별도로 설정하지 않았다면, WinForms의 기본 Font가 사용됩니다.

Windows/WinForms 환경에서는 일반적으로 시스템 기본 UI 폰트를 기준으로 하며, 현대 Windows에서는 Segoe UI 계열이 기본인 경우가 많습니다.

다만 OS 버전, DPI, WinForms 런타임/테마 등의 환경에 따라 실제 기본 Font가 달라질 수 있으므로 "항상 Segoe UI다"라고 고정해서 생각하면 안 됩니다.


실제로 확인하려면

현재 프로그램에서 다음 코드를 실행해 보면 됩니다.

 
MessageBox.Show(
    "Form Font : " + this.Font.Name +
    "\nSize : " + this.Font.Size);
 

또는:

 
MessageBox.Show(
    "Label Font : " + label1.Font.Name +
    "\nSize : " + label1.Font.Size);
 

예를 들어:

Form Font : Microsoft Sans Serif
Size : 8.25
 

처럼 나올 수도 있고,

환경에 따라:

Segoe UI
9
 

등으로 나올 수도 있습니다.


부모-자식 관계가 중요합니다

예를 들어:

 
this.Font = new Font("맑은 고딕", 10F);

panel1.Font = new Font("굴림", 12F);

// label1은 Font를 설정하지 않음
 

이라면:

Form
└─ Font = 맑은 고딕 10

   Panel
   └─ Font = 굴림 12

      Label
      └─ Font = 굴림 12  ← Panel에서 상속
 

입니다.

즉 가장 가까운 부모의 Font를 따라갑니다.


반대로 Label에 직접 Font를 지정하면

 
this.Font = new Font("맑은 고딕", 10F);

panel1.Font = new Font("굴림", 12F);

label1.Font = new Font("Arial", 20F);
 

이면:

Form
 └─ 맑은 고딕 10
     │
     └─ Panel
          └─ 굴림 12
               │
               └─ Label
                    └─ Arial 20  ← 직접 지정
 

이 됩니다.


그리고 지금 하시는 WinForms 변환 작업에서는 이 부분이 상당히 중요합니다.

기존 C1 컨트롤이나 다른 서드파티 컨트롤에서 컨트롤별 Font가 개별적으로 저장되어 있었다면, DataGridView, TreeView 등으로 바꾸면서 Font를 별도로 지정하지 않았을 때 부모 Form의 Font를 따라가면서 화면이 달라질 수 있습니다.

그래서 기존 화면과 동일하게 만들려면 단순히:

 
dataGridView1.Font = ...
 

만 보는 게 아니라,

Form.Font
   ↓
Panel.Font
   ↓
컨트롤.Font
 

의 Font 상속 구조 자체를 확인하는 것이 좋습니다.

질문)
BeginInit() / EndInit()을 생략한 경우와 생략하지 않았을경우에 극단적으로 차이를 보여주는 예제코드를 작성해주세요.

보통 WinForms 디자이너가 자동으로 넣어줍니다

예를 들어 어떤 컨트롤이 ISupportInitialize를 구현하고 있고, Visual Studio 디자이너가 해당 컨트롤을 초기화할 때 필요하다고 판단하면 .Designer.cs에 다음과 같이 생성합니다.

 
((System.ComponentModel.ISupportInitialize)(this.someControl)).BeginInit();

this.someControl.Location = new System.Drawing.Point(10, 10);
this.someControl.Name = "someControl";
this.someControl.Size = new System.Drawing.Size(200, 100);

((System.ComponentModel.ISupportInitialize)(this.someControl)).EndInit();
 

즉, 직접 매번 작성하는 것이 아닙니다.

특히 디자이너에서 컨트롤을 배치하고 속성을 변경하면 Visual Studio가 필요한 경우 자동으로 .Designer.cs에 넣어줍니다.


그래서 제가 한 문장으로 표현한다면:

BeginInit() / EndInit()의 존재 이유는 "초기화 작업을 하나의 원자적인 초기화 과정처럼 처리하기 위해서"이고, 그 결과로 불필요한 반복 처리와 처리시간을 줄일 수 있다.


답변)

BeginInit() / EndInit()의 차이가 극단적으로 보이도록 하려면, 실제 WinForms 컨트롤보다 ISupportInitialize를 직접 구현한 테스트 클래스를 만드는 것이 가장 명확합니다.

아래 예제에서는 BeginInit()이 없으면 설정할 때마다 무거운 작업을 실행하고, BeginInit() / EndInit()을 사용하면 마지막에 딱 한 번만 실행하도록 만들어 보겠습니다.

예제 1 — 차이가 극단적으로 보이는 코드

 
using System;
using System.ComponentModel;
using System.Diagnostics;

public class MyControl : ISupportInitialize
{
    private bool _initializing = false;

    private int _width;
    private int _height;
    private string _text;
    private int _value;

    public void BeginInit()
    {
        _initializing = true;

        Console.WriteLine(">>> BeginInit()");
    }

    public void EndInit()
    {
        _initializing = false;

        Console.WriteLine(">>> EndInit()");

        // 최종 설정이 끝났으므로 한 번만 실행
        HeavyWork();
    }

    public int Width
    {
        get { return _width; }
        set
        {
            _width = value;

            if (!_initializing)
                HeavyWork();
        }
    }

    public int Height
    {
        get { return _height; }
        set
        {
            _height = value;

            if (!_initializing)
                HeavyWork();
        }
    }

    public string Text
    {
        get { return _text; }
        set
        {
            _text = value;

            if (!_initializing)
                HeavyWork();
        }
    }

    public int Value
    {
        get { return _value; }
        set
        {
            _value = value;

            if (!_initializing)
                HeavyWork();
        }
    }

    private void HeavyWork()
    {
        Console.WriteLine(
            "HeavyWork 실행 : " +
            "Width=" + _width +
            ", Height=" + _height +
            ", Text=" + _text +
            ", Value=" + _value);

        // 극단적인 차이를 만들기 위한 가상의 무거운 작업
        System.Threading.Thread.Sleep(500);
    }
}
 

이제 생략한 경우를 보겠습니다.


1. BeginInit() / EndInit()을 생략

 
static void TestWithoutInit()
{
    MyControl control = new MyControl();

    Stopwatch sw = Stopwatch.StartNew();

    control.Width = 100;
    control.Height = 200;
    control.Text = "Hello";
    control.Value = 100;

    sw.Stop();

    Console.WriteLine();
    Console.WriteLine(
        "소요 시간 = " + sw.ElapsedMilliseconds + " ms");
}
 

실행하면 대략:

HeavyWork 실행 : Width=100, Height=0, Text=, Value=0
HeavyWork 실행 : Width=100, Height=200, Text=, Value=0
HeavyWork 실행 : Width=100, Height=200, Text=Hello, Value=0
HeavyWork 실행 : Width=100, Height=200, Text=Hello, Value=100

소요 시간 = 2000 ms
 

즉,

Width 설정
    ↓
HeavyWork()

Height 설정
    ↓
HeavyWork()

Text 설정
    ↓
HeavyWork()

Value 설정
    ↓
HeavyWork()
 

총 4번 실행됩니다.


2. BeginInit() / EndInit() 사용

이번에는:

 
static void TestWithInit()
{
    MyControl control = new MyControl();

    Stopwatch sw = Stopwatch.StartNew();

    control.BeginInit();

    control.Width = 100;
    control.Height = 200;
    control.Text = "Hello";
    control.Value = 100;

    control.EndInit();

    sw.Stop();

    Console.WriteLine();
    Console.WriteLine(
        "소요 시간 = " + sw.ElapsedMilliseconds + " ms");
}
 

실행하면:

>>> BeginInit()

>>> EndInit()

HeavyWork 실행 : Width=100, Height=200, Text=Hello, Value=100

소요 시간 = 500 ms
 

이번에는:

BeginInit()
    ↓
Width 설정       ─┐
Height 설정       │
Text 설정         ├── HeavyWork 실행 안 함
Value 설정        │
                  │
EndInit()         ─┘
    ↓
HeavyWork()       ← 딱 한 번
 

따라서 극단적으로 비교하면:

방식HeavyWork 횟수예상 시간
생략 4회 약 2초
사용 1회 약 0.5초

설정하는 속성이 100개라면:

BeginInit/EndInit 없음
→ HeavyWork 100회
→ 약 50초

BeginInit/EndInit 사용
→ HeavyWork 1회
→ 약 0.5초
 

이렇게까지 차이가 날 수 있습니다.


그런데 실제 WinForms에서는 조금 다릅니다

여기가 중요합니다.

실제 ISupportInitialize 컨트롤이 반드시 위와 같이 동작한다는 뜻은 아닙니다.

BeginInit() / EndInit()의 정확한 동작은 그 컨트롤을 만든 개발자가 어떻게 구현했느냐에 따라 달라집니다.

예를 들어 실제 컨트롤 내부가:

 
public void BeginInit()
{
    _initializing = true;
}

public void EndInit()
{
    _initializing = false;
    Rebuild();
}
 

처럼 만들어져 있을 수도 있고,

 
public void BeginInit()
{
    // 아무 것도 안 함
}

public void EndInit()
{
    // 아무 것도 안 함
}
 

일 수도 있습니다.

따라서

ISupportInitialize를 구현했다 = BeginInit/EndInit을 빼면 반드시 문제가 발생한다

는 것은 아닙니다.


가장 중요한 핵심

BeginInit() / EndInit()의 본질은 "초기 설정을 하는 동안 컨트롤에게 아직 최종 상태가 아니라고 알려주는 것"입니다.

예를 들어 디자이너가 다음처럼 20개의 속성을 설정한다고 생각해 보겠습니다.

 
control.Width = 100;
control.Height = 200;
control.Text = "TEST";
control.Value = 10;
control.Font = ...;
control.Color = ...;
control.DataSource = ...;

// ...
 

이때 컨트롤 입장에서:

Width = 100
    ↓
"아직 초기화 중이네"

Height = 200
    ↓
"아직 초기화 중이네"

Text = TEST
    ↓
"아직 초기화 중이네"

...

마지막
    ↓
EndInit()
    ↓
"이제 설정 끝났구나!"
    ↓
실제 초기화
 

라는 구조를 만들 수 있습니다.


그리고 BeginUpdate()와 비교하면 더 쉽게 이해됩니다

지금 작업하시는 TreeView의 경우:

 
treeview.BeginUpdate();

treeview.Nodes.Clear();

treeview.Nodes.Add(...);

treeview.EndUpdate();
 

이것은:

화면 그리기를 잠시 중단했다가 한 번에 보여준다.

입니다.

반면:

 
control.BeginInit();

control.Width = 100;
control.Height = 200;
control.Text = "TEST";

control.EndInit();
 

이것은:

컨트롤의 초기 설정 작업을 하나의 초기화 과정으로 묶는다.

입니다.

즉,

BeginInit / EndInit
        ↓
"컨트롤 초기화"

BeginUpdate / EndUpdate
        ↓
"화면 업데이트"
 

라고 구분하면 거의 정확합니다.

한마디로 표현하면:

Windows에 설치된 하나의 Redis/MySQL 서비스를 Windows의 C# Client와 WSL Ubuntu의 APM Server가 TCP/IP를 통해 공동 사용한다.


1. WSL의 가상 네트워크

WSL Ubuntu는 Windows와 별도의 Linux 환경이지만, Windows Host와 네트워크로 연결되어 있습니다.

따라서 Ubuntu 입장에서는 Windows에서 실행 중인 Redis/MySQL을:

IP 주소 + Port
 

로 접근할 수 있습니다.

예를 들어:

Redis → Windows_IP:6379
MySQL → Windows_IP:3306
 

2. Redis/MySQL의 TCP 서버

Redis와 MySQL은 단순히 "Windows 프로그램"이 아닙니다.

핵심적으로는 TCP 서버입니다.

Redis
↓
TCP Listen
↓
0.0.0.0:6379 또는 특정 IP:6379
 
MySQL
↓
TCP Listen
↓
0.0.0.0:3306 또는 특정 IP:3306
 

따라서 접속하는 프로그램이 Windows 프로그램이든 Linux 프로그램이든 상관없습니다.

Windows C# ────────┐
│
WSL Ubuntu ────────┼──► TCP ──► Redis :6379
│
└──► TCP ──► MySQL :3306
 

Redis/MySQL이 어떤 OS에서 실행되고 있는지는 클라이언트 입장에서는 중요하지 않습니다.


설치하려는 ScottPlot.WinForms 5.1.59는 .NET Framework 4.6.1을 지원하지 않습니다.

따라서 이전에 제가 말씀드린 "4.6.2 이상도 지원"이라는 부분은 현재 설치하려는 ScottPlot 5.1.59 기준으로는 정확하지 않았습니다.

가장 적절한 해결 방법

현재 프로젝트를 가능하다면:

.NET Framework 4.6.1
↓
.NET Framework 4.8
 

로 올리는 것을 가장 추천합니다.

특히 지금 프로젝트가 기존 C1Chart 기반의 오래된 WinForms 프로그램이므로, 당장 .NET 8로 전환하는 것보다 .NET Framework 4.8로 먼저 올리는 것이 훨씬 안전합니다.


1. 현재 프로젝트의 Target Framework 변경

Visual Studio에서:

대상 프레임워크
.NET Framework 4.6.1
 

을

.NET Framework 4.8
 

로 변경합니다.

프로젝트를 다시 로드하라는 메시지가 나오면 재로드합니다.


2. 다시 설치

Package Manager Console에서:

 
Install-Package ScottPlot.WinForms
 

실행합니다.

그러면 현재처럼

.NETFramework,Version=v4.6.1
 

이 아니라

.NETFramework,Version=v4.8
 

을 대상으로 패키지를 설치하게 됩니다.


만약 .NET Framework 4.6.1을 절대 변경할 수 없다면

그 경우에는 ScottPlot 5.1.59를 사용하면 안 됩니다.

ScottPlot의 구버전 중 현재 프로젝트와 호환되는 버전을 찾아야 합니다.


Windows 11에서는 .NET Framework 4.8 계열이 기본적으로 포함되어 있습니다. Microsoft 공식 문서에서도 Windows 11 21H2에는 4.8, 이후 버전에는 4.8.1이 포함되어 있다고 명시합니다.

중요한 점은 오프라인 설치 Windows 11이라는 조건입니다.

Windows 11 버전별

Windows 11기본 포함
21H2 (22000) .NET Framework 4.8
22H2 (22621) .NET Framework 4.8.1
23H2 (22631) .NET Framework 4.8.1
24H2 (26100) .NET Framework 4.8.1
25H2 (26200) .NET Framework 4.8.1

즉, Windows 11이라면 최소한 .NET Framework 4.8이 기본적으로 들어있다고 생각하셔도 됩니다.

그리고 아주 중요한 부분이 하나 있습니다.

4.8.1이 설치되어 있어도 4.8 프로젝트를 실행할 수 있습니다

.NET Framework 4.x는 In-place Update 방식이라 한 시스템에 4.6.1, 4.8, 4.8.1을 각각 독립적으로 설치하는 구조가 아닙니다. 4.8.1은 기존 4.x를 대체하며 4.8용으로 작성된 프로그램도 지원합니다.

따라서 현재 프로젝트를:

.NET Framework 4.6.1
↓
.NET Framework 4.8
 

로 변경해도, Windows 11 배포 PC에서 별도의 .NET Framework 4.8 설치 프로그램을 반드시 실행해야 하는 것은 아닙니다.

다만 개발 PC에서 Visual Studio가 **.NET Framework 4.8 Developer Pack / Targeting Pack**을 필요로 할 수 있습니다. 이것은 런타임과 별개의 문제입니다. Microsoft도 개발 환경에서는 Developer Pack이 필요할 수 있다고 설명합니다.

지금 상황에서는

현재 APM이 .NET Framework 4.6.1이고 ScottPlot 5 설치가 실패했으므로 저는 다음 순서로 진행하는 것을 추천합니다.

현재 APM
.NET Framework 4.6.1
↓
Visual Studio에서 Target Framework 4.8
↓
Clean / Rebuild
↓
Install-Package ScottPlot.WinForms
↓
C1Chart → ScottPlot 변환
 

그리고 오프라인 배포를 고려한다면 4.8보다 4.8.1로 올릴 필요가 있는지도 별도로 판단할 수 있습니다. 현재 Windows 11이 주 대상이라면 4.8.1이 기본 포함되는 버전이 많기 때문에 4.8.1을 타겟으로 하는 것도 가능합니다.

Windows 11에서는 명령 프롬프트(CMD)에서 확인하는 방법(.NET Framework 4.8)

1. CMD에서 바로 확인

CMD를 열고 다음을 실행하세요.

 
reg query "HKLM\SOFTWARE\Microsoft\NET Framework Setup\NDP\v4\Full" /v Release
 

예를 들어:

Release REG_DWORD 0x81e...
 

처럼 나오면 됩니다.

다만 Release 숫자를 직접 해석하기 번거로우므로 다음 명령을 추천합니다.

2. PowerShell에서 버전까지 확인

PowerShell에서:

 
$release = Get-ItemPropertyValue "HKLM:\SOFTWARE\Microsoft\NET Framework Setup\NDP\v4\Full" -Name Release
if ($release -ge 533320) {
".NET Framework 4.8.1 이상"
}
elseif ($release -ge 528040) {
".NET Framework 4.8"
}
else {
".NET Framework 4.8 미만"
}
 

Microsoft 공식 기준으로 Release 값이 528040 이상이면 .NET Framework 4.8 이상입니다. Windows 11의 4.8은 일반적으로 Release 값 528449이고, 4.8.1은 Windows 11 버전에 따라 533320 또는 533509입니다.

3. 가장 간단하게 한 줄로

현재 PC가 4.8 이상인지 YES/NO만 확인하려면 CMD에서:

 
powershell -command "(Get-ItemPropertyValue 'HKLM:\SOFTWARE\Microsoft\NET Framework Setup\NDP\v4\Full' -Name Release) -ge 528040"
 

결과가:

True
 

이면 .NET Framework 4.8 이상 설치입니다.


그리고 한 가지 정정할 부분이 있습니다. Windows 11 22H2 이상은 .NET Framework 4.8.1이 기본 포함되어 있습니다. 21H2는 4.8이 기본 포함입니다.

따라서 지금 사용하시는 PC에서 위 명령을 실행한 결과를 보여주시면, 현재 APM 프로젝트의 4.6.1을 4.8 또는 4.8.1 중 어느 것으로 올리는 게 좋은지 바로 판단해드릴 수 있습니다.

현재 코드에서는 BLPop()을 다시 호출할 때 기존 RedisClient의 연결을 통해 다시 통신을 시도합니다. 다만 "새로운 TCP 연결을 무조건 새로 만든다"와 "Redis 서버에 다시 접속을 시도한다"는 것은 구분해야 합니다.

현재 코드 흐름은:

 
_receiveRedis = new RedisClient(ipAddress, Convert.ToInt32(portNo));
 

이것은 Init()에서 처음 한 번만 실행됩니다.

그 이후에는 계속 같은 _receiveRedis 객체에 대해:

 
jsonBytes = _receiveRedis.BLPop(key, 10);
 

을 호출합니다.

그리고 Worker가 끝나면:

 
_recvWorker.RunWorkerAsync();
 

를 다시 호출합니다.

즉:

Init()
│
└─ new RedisClient()
│
▼
_receiveRedis
│
├──── BLPop() ──→ 접속/통신
│
├──── BLPop() ──→ 다시 통신
│
├──── BLPop() ──→ 다시 통신
│
└──── BLPop() ──→ 다시 통신
 

중요한 점

RunWorkerAsync()가 다시 실행될 때:

 
new RedisClient(...)
 

를 다시 하는 것은 아닙니다.

따라서 코드상으로는:

❌ Worker 재시작
→ RedisClient 새로 생성
→ TCP 연결 새로 생성
 

이 아닙니다.

정확히는:

⭕ Worker 재시작
→ 기존 _receiveRedis 사용
→ BLPop() 호출
→ ServiceStack.Redis가 필요하면 연결/소켓을 다시 처리
 

입니다.

여기서 실제 TCP 소켓을 내부적으로 재사용하는지, 끊어진 소켓을 ServiceStack.Redis가 내부적으로 다시 연결하는지는 현재 올려주신 애플리케이션 코드만으로는 확정할 수 없습니다. 그 부분은 ServiceStack.Redis 라이브러리의 RedisClient 구현에 해당합니다.


그래서 현재 코드에서 확실하게 말할 수 있는 것은

Redis 서버가 죽어 있을 때

 
BLPop(key, 10)
 

→ 예외 발생
→ recvWorker_DoWork() 종료
→ recvWorker_RunWorkerCompleted() 실행
→ RunWorkerAsync()
→ 다시 BLPop(key, 10) 호출

이라는 반복 재시도 구조입니다.

따라서 서버가 복구되면 이후 BLPop() 호출에서 정상적으로 통신이 이루어질 가능성이 있습니다.

다만 "서버가 복구되면 반드시 새 TCP 연결을 맺는다"까지 현재 코드만으로 보장할 수는 없습니다.


그리고 한 가지 더 중요한 문제가 있습니다.

현재:

 
catch (Exception rExcep)
{
Log($"[RECV][ERROR][Exception] {rExcep}");
}
 

에서 Redis 접속 오류를 그냥 기록하고 끝냅니다.

그 후 Completed에서 무조건 다시 Worker를 시작합니다.

따라서 현재 구조는 사실상:

BLPop() → Redis 통신 실패 → 0초에 가깝게 다시 BLPop() → 실패 → 다시 BLPop()

이 될 수도 있습니다.

즉 재접속 간격을 별도로 두는 Thread.Sleep()이나 backoff 로직은 현재 코드에는 없습니다.

+ Recent posts